十張圖把硬連線推論拆開來看
大型模型推論時,時間和能量常常花在搬權重,不只花在乘加。GPU 每吐下一個 token,往往又得把參數再抓一次。Taalas 走的是比較硬的路:把特定模型的權重與資料流固化進晶片,少搬、少做重複工作。
這十張漫畫是教學抽象,不是 Taalas 未公開的電路圖。同一條 activation x 碰上大量低位元固定權重時,可以先準備有限組候選乘積,再讓權重代碼選路。圖給直覺;文字對到機制、限制,以及哪些句子不能推論過頭。
先把資料重用看清楚,再回頭看繞線、精度、流片,以及換模型要付的代價。
1. 模型不是載入,而是做進晶片
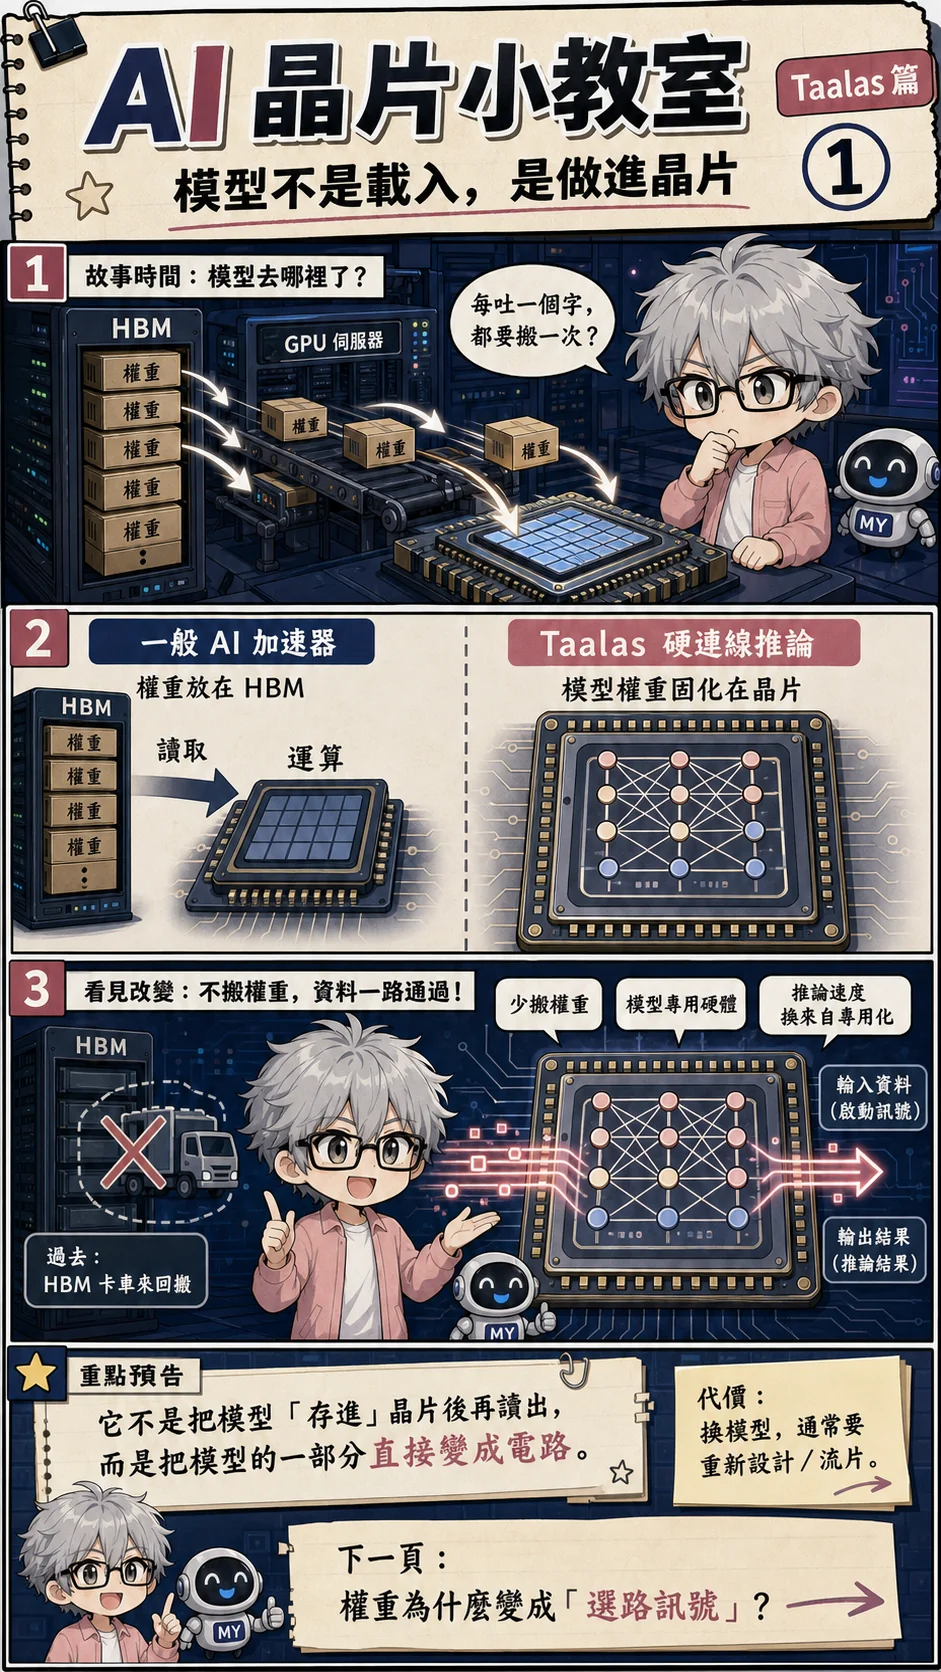
左邊是一疊標著「權重」的 HBM 箱子;右邊 GPU 伺服器每吐一個字,就要把箱子再搬一次。重點不在諷刺 GPU 算得慢,而在 decode 時反覆取權重的成本。權重很大、又一直被重複使用時,搬運本身就會變成瓶頸。
圖的中間把兩條路攤開。一般 AI 加速器:權重放在 HBM,讀取,再送進運算單元。Taalas 硬連線推論:模型權重固化在晶片裡,資料沿著片上路徑走。末格更直白——HBM 卡車被打叉;activation 從一邊進來,推論結果從另一邊出去。漫畫把效益收成三句:少搬權重、模型專用硬體、推論速度來自專用化。
「做進晶片」最容易被讀過頭。它不是拿火燒模型,也不是把普通權重檔存進 ROM、之後仍照舊讀出來算。更準確的講法是:模型結構與固定權重參與了晶片的實體實作,資料路徑因此能為這個模型高度客製化。
Taalas 對外描述的方向叫 total specialization:一顆晶片服務特定模型,儲存與運算緊密合併。官方也說 HC1 這套示範系統不依賴 HBM、先進封裝、3D 堆疊或液冷。[1] 那是廠商對自家系統的描述,不是「所有硬連線推論都不必 HBM」的物理定律。
彈性換效率,就是這裡的取捨。一般加速器保留載入不同模型的自由;Taalas 用模型專用晶片減少權重搬移。若要改動固化的模型結構或基礎權重,通常得重新設計或流片;這不表示所有設定都固定。Taalas 官方仍列可配置 context window 與 LoRA 支援,兩者要和更換整個基礎模型分開看。
2. 權重換了一個角色
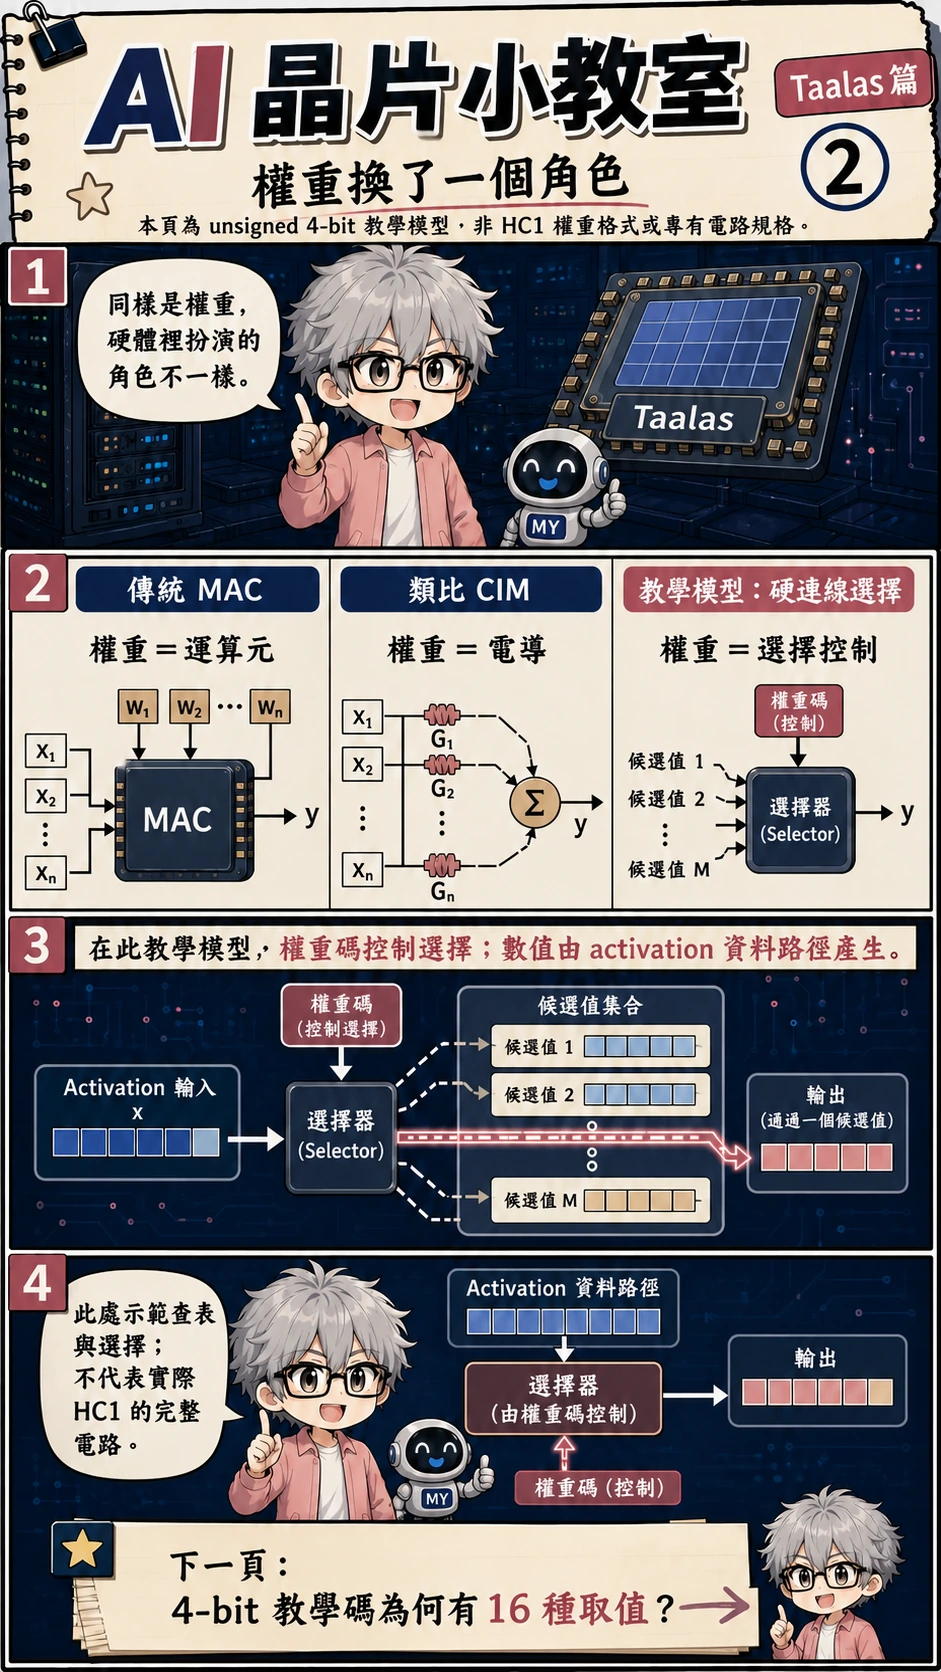
同樣叫權重,硬體裡的工作可以完全不同。傳統 MAC 裡,x 和 w 都是運算元,乘完再累加。類比 CIM 常把權重映射成元件電導,用電壓與電流做乘加。這套教學模型則把低位元權重當成索引:先有一組候選值,權重碼去挑其中一個。
選擇器那一格把關係畫清楚:activation x 從左邊進來,權重碼當控制,候選值集合在中間,輸出只放行其中一個候選。先別急著說「沒有乘法」——數值仍由 activation 資料路徑產生。選擇器不負責發明答案,它只決定哪一條路能通過。
這是教學抽象,不是 transistor-level 的 HC1 電路圖。Taalas 現行官方說明把第一代寫成自訂 3-bit 基底,Silicon Llama 混合 3-bit 與 6-bit 參數;第二代才採標準 4-bit 浮點格式。[1] 所以本課 unsigned 4-bit、16 格候選表與 one-hot 只是在建立功能直覺,不能拿來宣稱 HC1 的實際參數格式、電晶體數或閘級網表。
順便分清楚:圖上類比 CIM 那一列畫的是電導式乘加;業界還有數位 CIM,權重仍以 bit 存放、乘加邏輯在周邊。別把「CIM」收成單一實作。後文若出現「select-in-memory, compute-in-periphery」,那是本文自己的類比,不是標準產業分類。
在這套模型裡,權重比較像選路開關,而不是自己長出乘積。下一張會說明為什麼 4-bit 會讓候選集合突然變小、而且可以重用。
3. 4-bit 為什麼只剩 16 種候選?
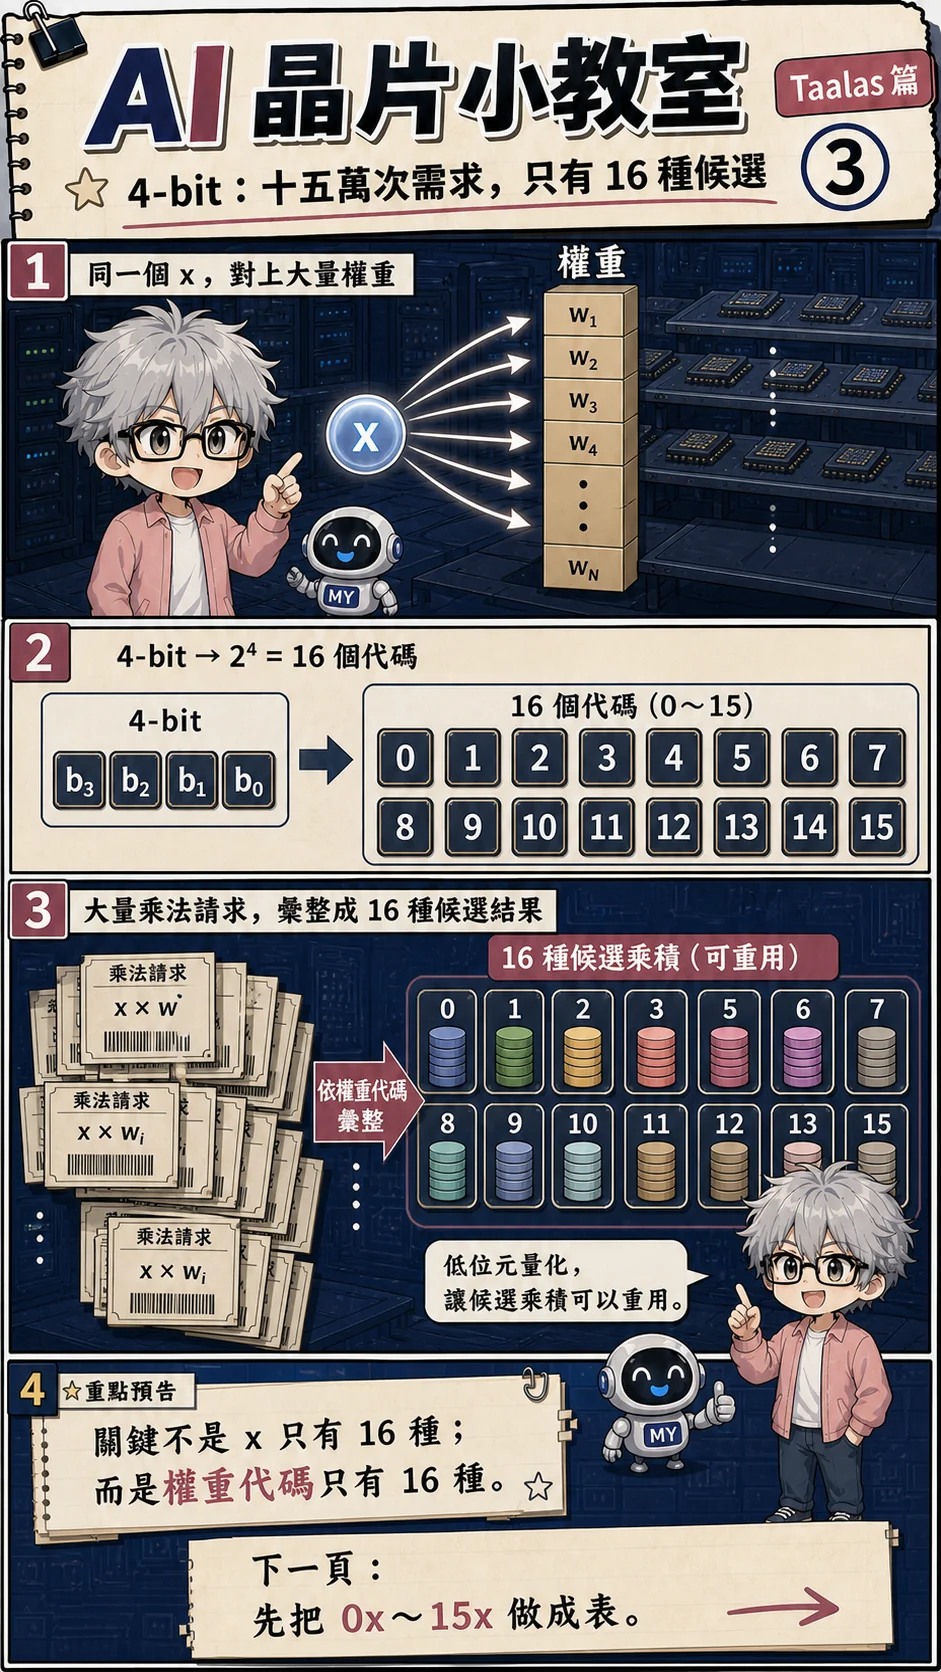
一個 x,對面卻是 w1 到 wn 一大疊——矩陣裡同一列或同一個輸入維度,常常就是這種形狀。4-bit 拆開之後,b3 b2 b1 b0 只能編出 2⁴ = 16 個代碼,也就是 0 到 15。
真正的轉折在候選彙整:左邊一疊「乘法請求」票(x × w、x × wi、x × wj),右邊收成 16 種候選乘積。標題寫「十五萬次需求,只有 16 種候選」——那是教室用的數量級,用來強調「很多次」,不是 Taalas 某層真實的乘法次數。低位元量化的意義在這裡:權重再多,索引仍然落在這 16 個位置。
容易讀錯的一句是:不是 x 只有 16 種,是權重代碼只有 16 種。同一個 x 的候選乘積因此可以重用;可重用集合的大小由權重位元數決定,不由 activation 的數值範圍決定。
實際模型不一定是 unsigned 0~15。有號格式、縮放係數、分組量化、非均勻碼本,都會改變硬體要準備的候選與精度損失。這裡先用最乾淨的 16 格建立直覺;產品數字不能直接從這張表抄出去。
4-bit 真正拆開的是兩件事:「要乘多少次」和「要準備幾種答案」。次數可以很大;答案種類卻被位元數鎖住。
4. 先建候選表,再讓權重查表
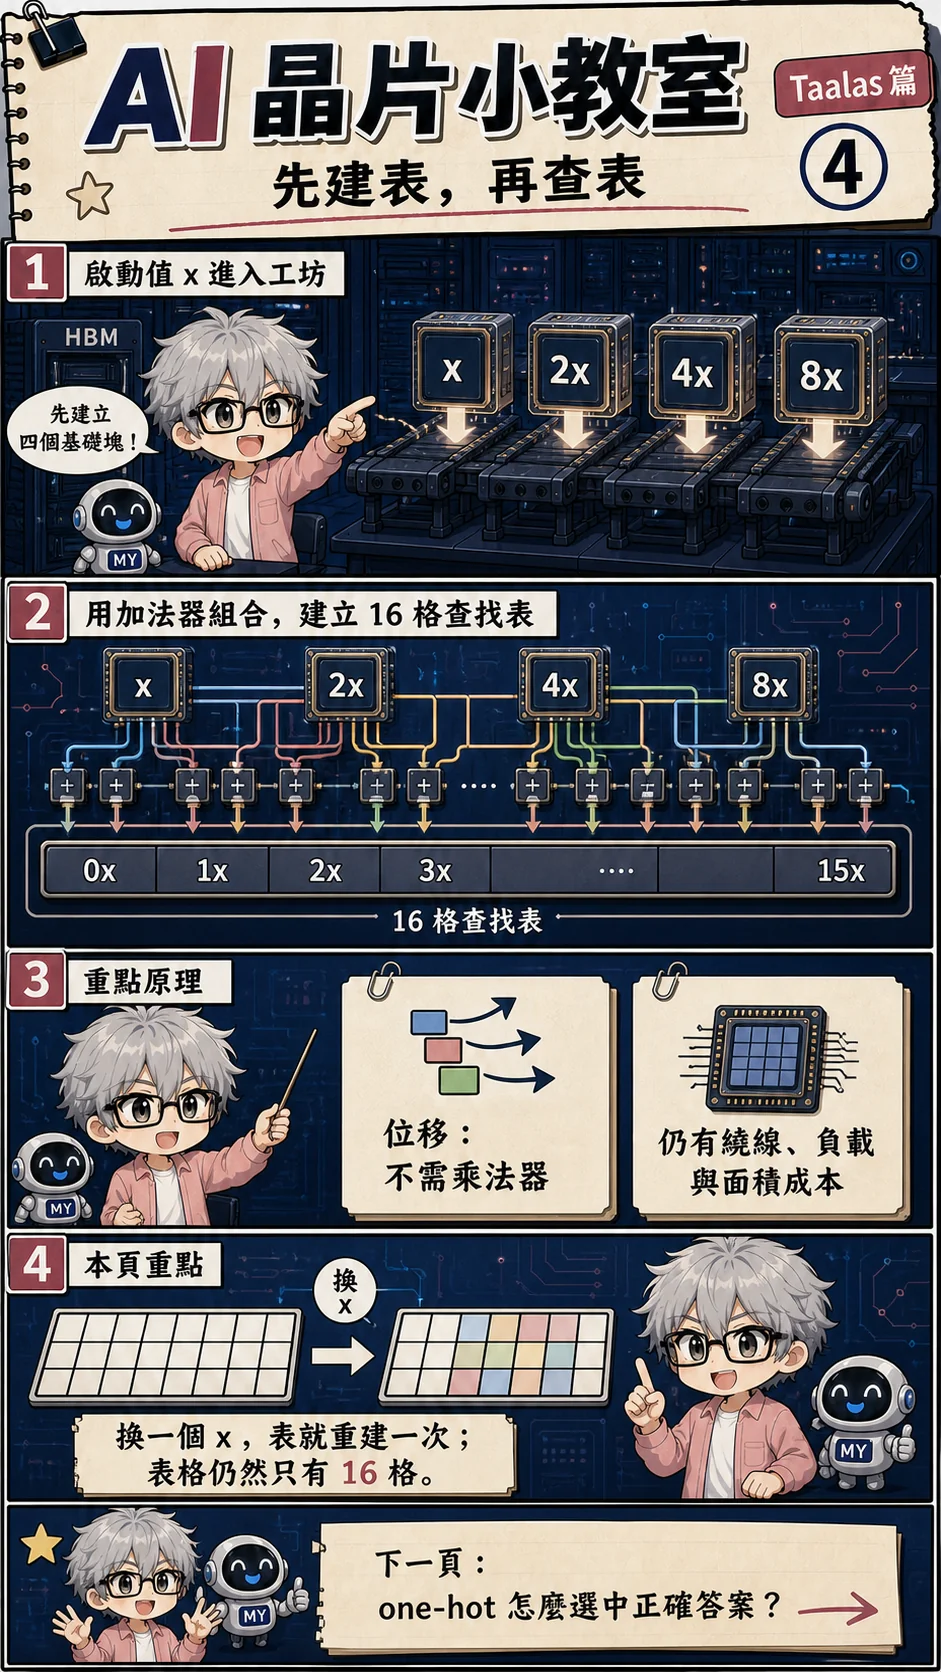
先做出四個基礎值:x、2x、4x、8x。二進位左移一格就是乘 2,不必為這三個倍數各放一顆通用乘法器。再用加法器組合成 0x 到 15x——例如 6x = 4x + 2x,15x = 8x + 4x + 2x + x。表一旦建好,後面那些固定權重就來查同一張表。
「位移免費」這種簡稱會誤導人。位移確實不需要通用乘法器,可是線還是要拉、負載還是在、面積與時序一樣要付。真正省下的是「不要為每一個權重各做一次完整乘法」;不是晶片上憑空多出一張不佔資源的表。
換一個 x,表裡每一格都要重建;格數卻仍由權重代碼數決定,所以還是 16 格。表的寬度跟模型有多大無關,跟權重位元數有關;表的內容則跟著當下這個 activation 走。真正晶片也不一定擺一張肉眼可見的 16 格 ROM——合成後可能是多工器、邏輯閘、或其他等效資料路徑。圖畫的是功能關係,不是 floorplan。
成本沒有消失,只是搬家:從「每個權重各乘一次」,挪到「建表 + 選路 + 把候選值送到許多選擇器」。下一張看權重代碼怎麼指出「我要第幾格」。
5. one-hot:一次只打開一條路
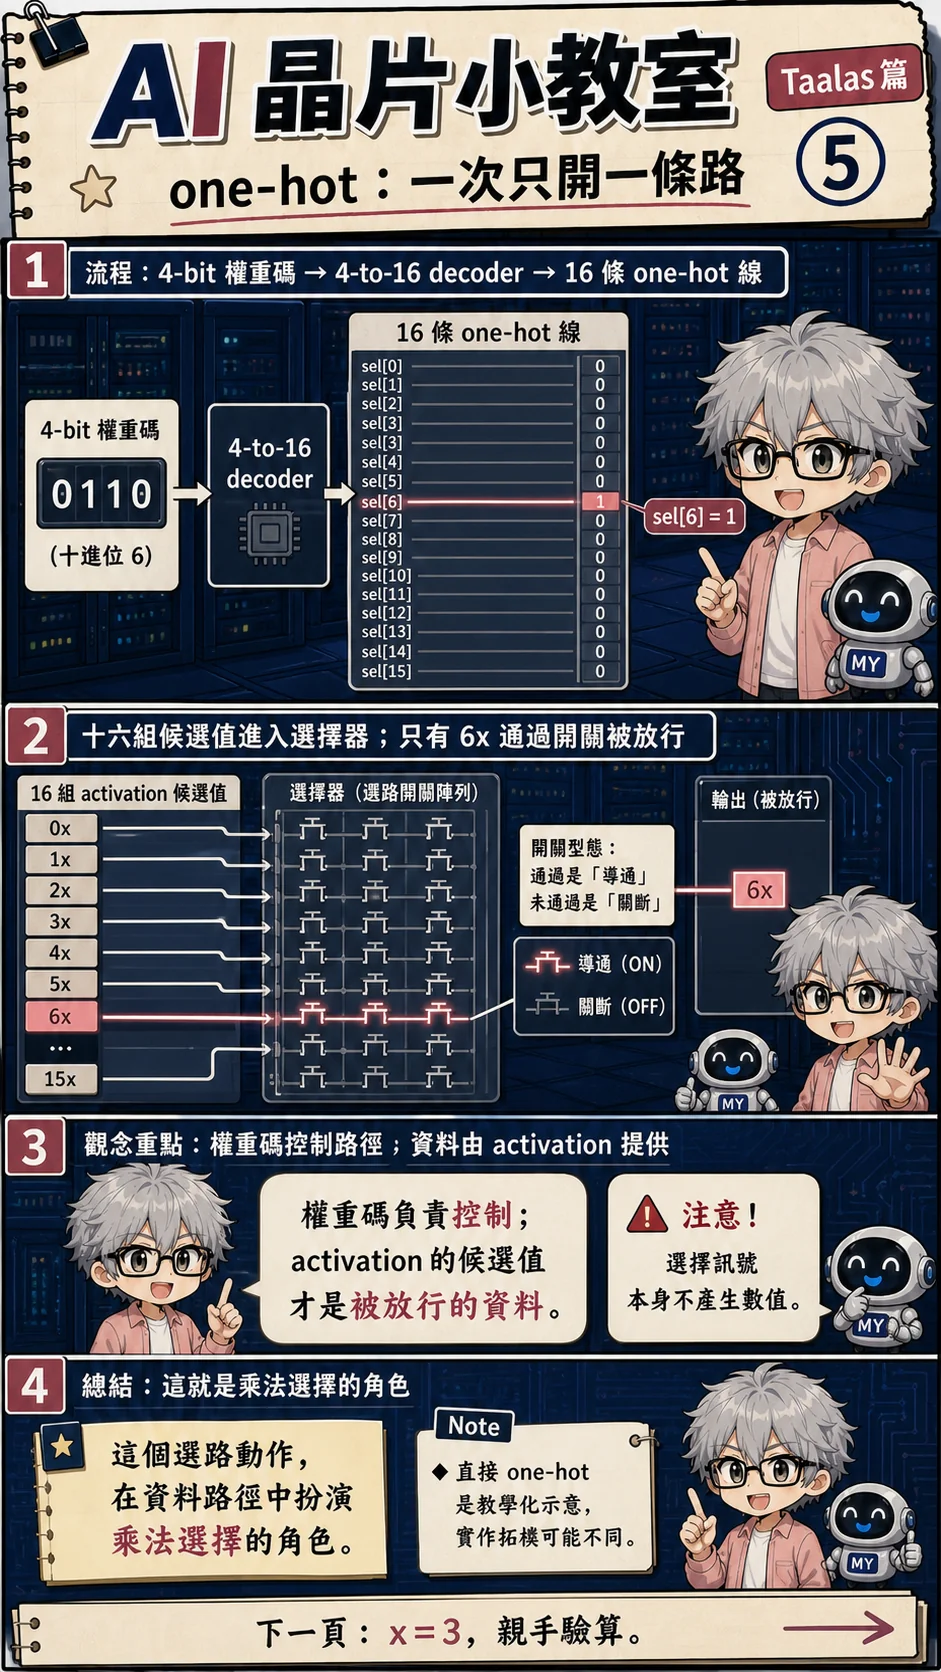
以 0110 為例:十進位是 6,進 4-to-16 decoder 之後,16 條 one-hot 線裡只有 sel[6] 為 1,其餘為 0。one-hot 的意思很字面——一次只熱一條。
16 組 activation 候選值送進選擇器;漫畫畫成開關陣列,通過是導通、未通過是關斷。只有 6x 那一條被放行。這些開關本身不攜帶乘積數值;數值已經在候選線上。權重碼負責控制,activation 的候選值才是被放行的資料。
直接 one-hot 最好畫懂,實作卻可能改用樹狀多工器或其他編碼,來減輕佈線與 fan-out。圖上的電晶體顆數,不能直接當成 HC1 的 gate count。位元數往上加,直接 one-hot 的路數按 2ⁿ 成長:3-bit 8 路、4-bit 16 路、8-bit 256 路——第 9 張會回頭算這筆代價。Decoder 本身也有邏輯閘與繞線,不是「一顆電晶體通或不通」就能概括整個選路成本。
權重負責開門;數字還是從 activation 那邊走過來。別把開關當成乘法器。下一張用 x = 3 把表算出來對一下。
6. x = 3,查表一次看懂
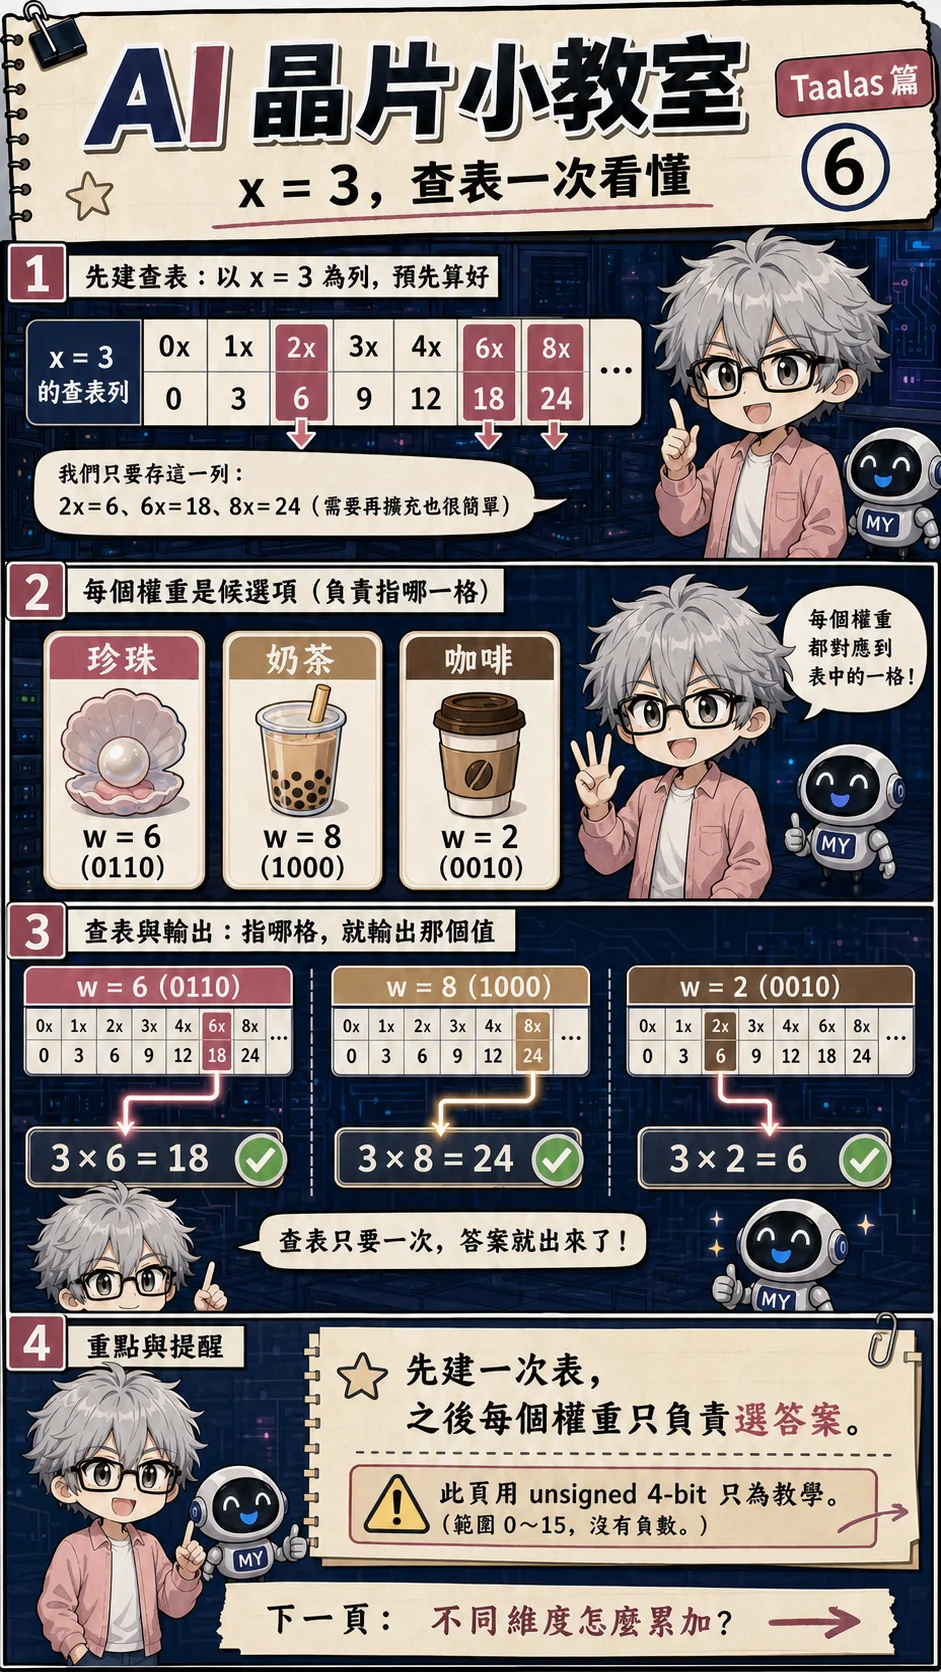
x = 3 時,0x, 1x, 2x, 3x, 4x, 6x, 8x 就是 0、3、6、9、12、18、24。位移那幾個特別好認:2x=6、4x=12、8x=24。表建一次,後面就反覆查。
珍珠、奶茶、咖啡在這頁是三個不同的權重,不是三種飲料維度:w = 6 (0110)、w = 8 (1000)、w = 2 (0010)。各指向表上的一格之後,得到 18、24、6。數學沒變——3×6=18、3×8=24、3×2=6;變的是「乘積被先算好,權重只負責選」。
圖上的黃色警告值得一起讀:此頁用 unsigned 4-bit 只作教學,範圍 0~15,沒有負數。真實矩陣乘法還要處理有號值、縮放、飽和、累加位寬,以及不同層的數值範圍。小例子證明查表能重現乘積,不是證明整個 LLM 只靠一張 16 格表就能跑完。
下一張會把同一個記憶鉤子轉個方向:珍珠、奶茶、咖啡變成輸出端的候選,輸入端則換成「奶茶/甜甜/QQ」三個維度。比喻會換角色,數字關係不會。表建一次就夠;每個權重只負責選答案。
7. 每個維度查一次,最後再累加
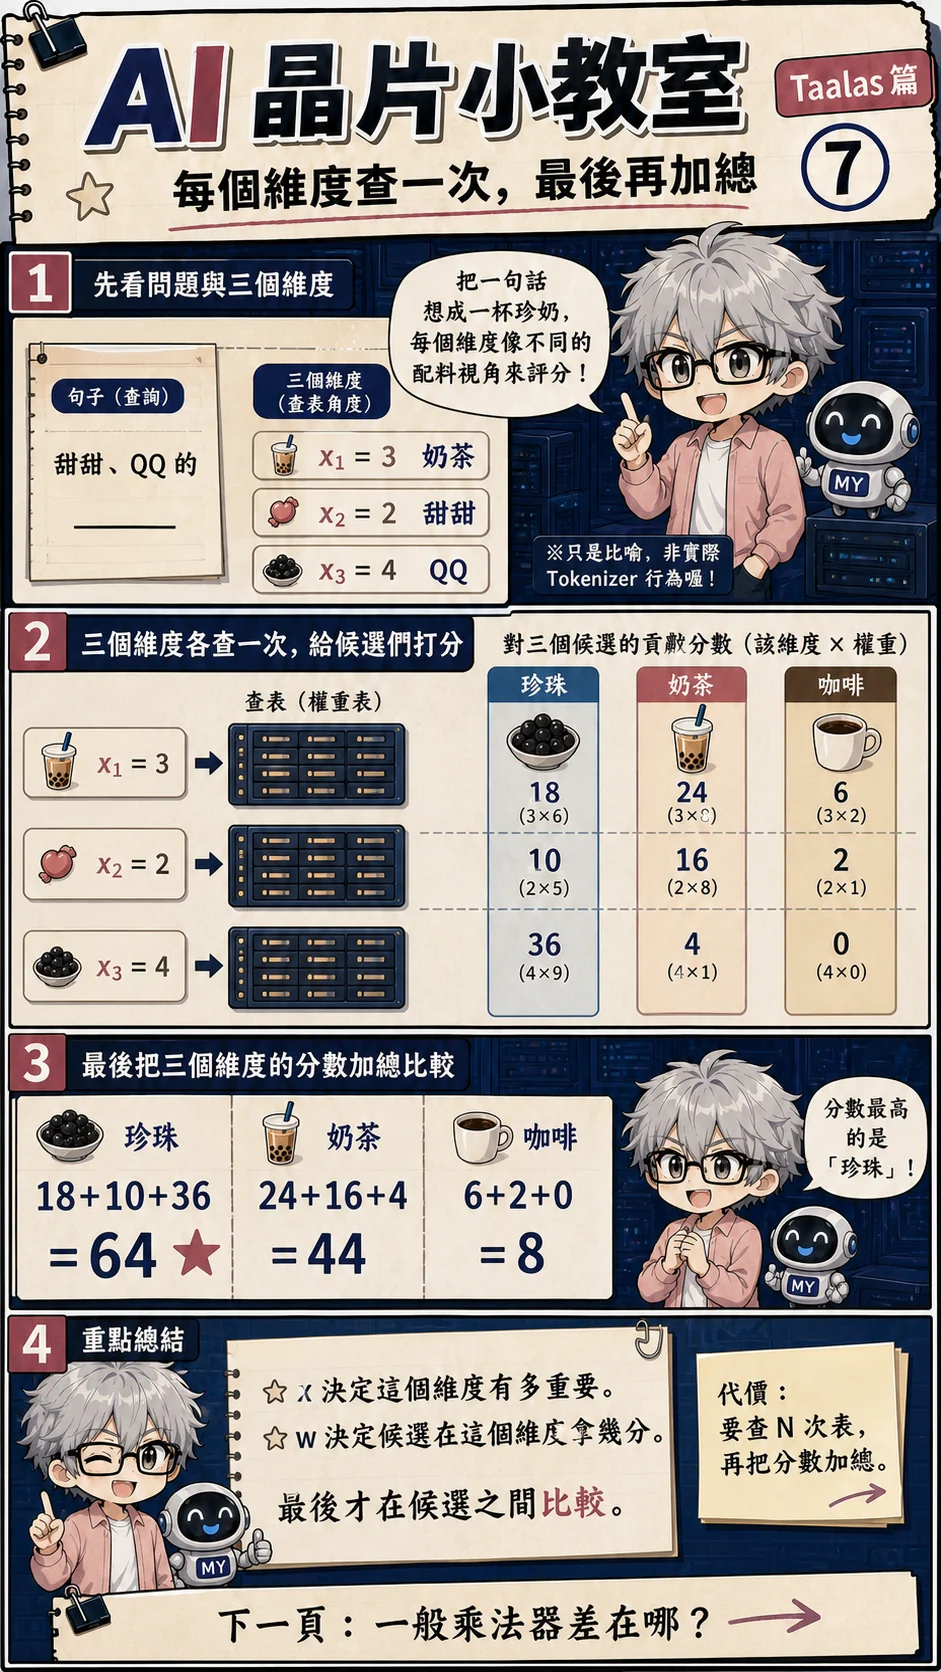
矩陣向量乘法不是查一次就結束。把一句話想成一杯珍奶時,每個輸入維度像不同配料:x1 = 3(奶茶)、x2 = 2(甜甜)、x3 = 4(QQ)。圖上有註:這只是比喻,不是實際 tokenizer 行為——語言模型不會把「甜甜」「QQ」做成三個固定人工維度。
每個 x 建一張表,再對珍珠、奶茶、咖啡三個候選查權重、打分數:
- 珍珠:
3×6=18,2×5=10,4×9=36 - 奶茶:
3×8=24,2×8=16,4×1=4 - 咖啡:
3×2=6,2×1=2,4×0=0
加總之後:珍珠 18+10+36=64,奶茶 24+16+4=44,咖啡 6+2+0=8。分數最高的是珍珠。重點不是珍奶店選品,而是輸出通道要等所有輸入維度的貢獻到齊,才能比較。
角色可以這樣記:x 決定這個維度有多重要;w 決定某個候選在這個維度拿幾分;最後才在候選之間比較。代價寫在圖上:要查 N 次表,再把分數加總。硬體上這些維度通常平行處理;漫畫用序列是為了讓每一筆分數從哪來跟得上。共享一個 x、查出貢獻、累加,再換下一個 x——流程就這樣轉。
8. 算法沒變,重用方式變了
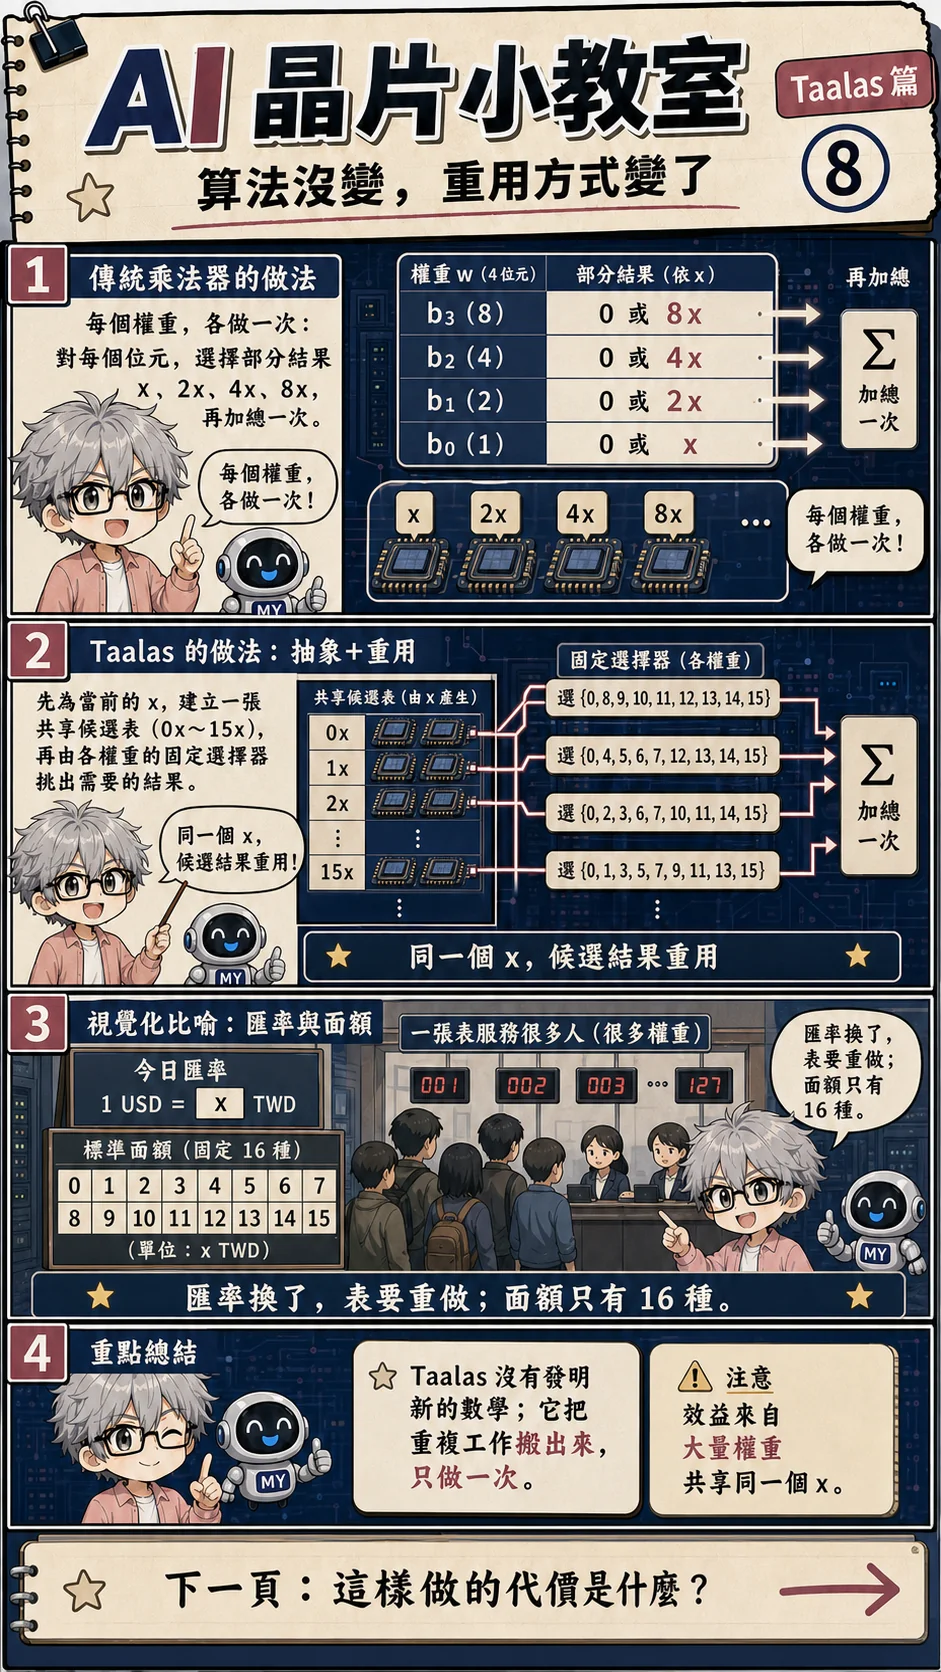
對照上一張的累加之後,回頭看一般乘法器會更清楚。4-bit 權重的每一個 bit 決定要不要加 8x、4x、2x、x,再加總——本來就是移位與部分積。麻煩在於:每個權重都各自做一次。權重一多,同樣的 x、2x、4x、8x 就被重做很多遍。
共享表那一側把重複工作抽到中間:先為當前的 x 建 0x~15x,再送到一排固定選擇器。同一個 x,候選結果重用。加總還是要做,只是部分積不再由每個權重各自重建。
匯率櫃檯只是記憶鉤子。今日匯率 1 USD = x TWD 對應當前的 x;標準面額 0 到 15 對應低位元 w;櫃檯前的人對應很多固定權重。匯率換了,表要重做;面額種類仍然只有 16 種。別把它讀成外匯硬體或 tokenizer。
這套教室模型並沒有發明新的數學;它把重複工作搬出來,只做一次。效益來自大量權重共享同一個 x。共享不夠、activation 型別太窄、量化碼本太複雜,或繞線與時序把資料路徑拖住,查表優勢就會縮水。2026 年一篇針對 1.58-bit LLM LUT 加速器的研究也指出,最佳架構高度受 activation 資料型別影響;對小整數型別,LUT 重用的收益會變小。[4] 那篇是相關設計空間證據,不是 HC1 實作說明。
結果仍是 x × w。變的是哪些中間值值得抽出來共用,哪些還是每個權重自己做比較划算。下一張把這條路的帳單攤開。
9. 專用化很快,也有代價
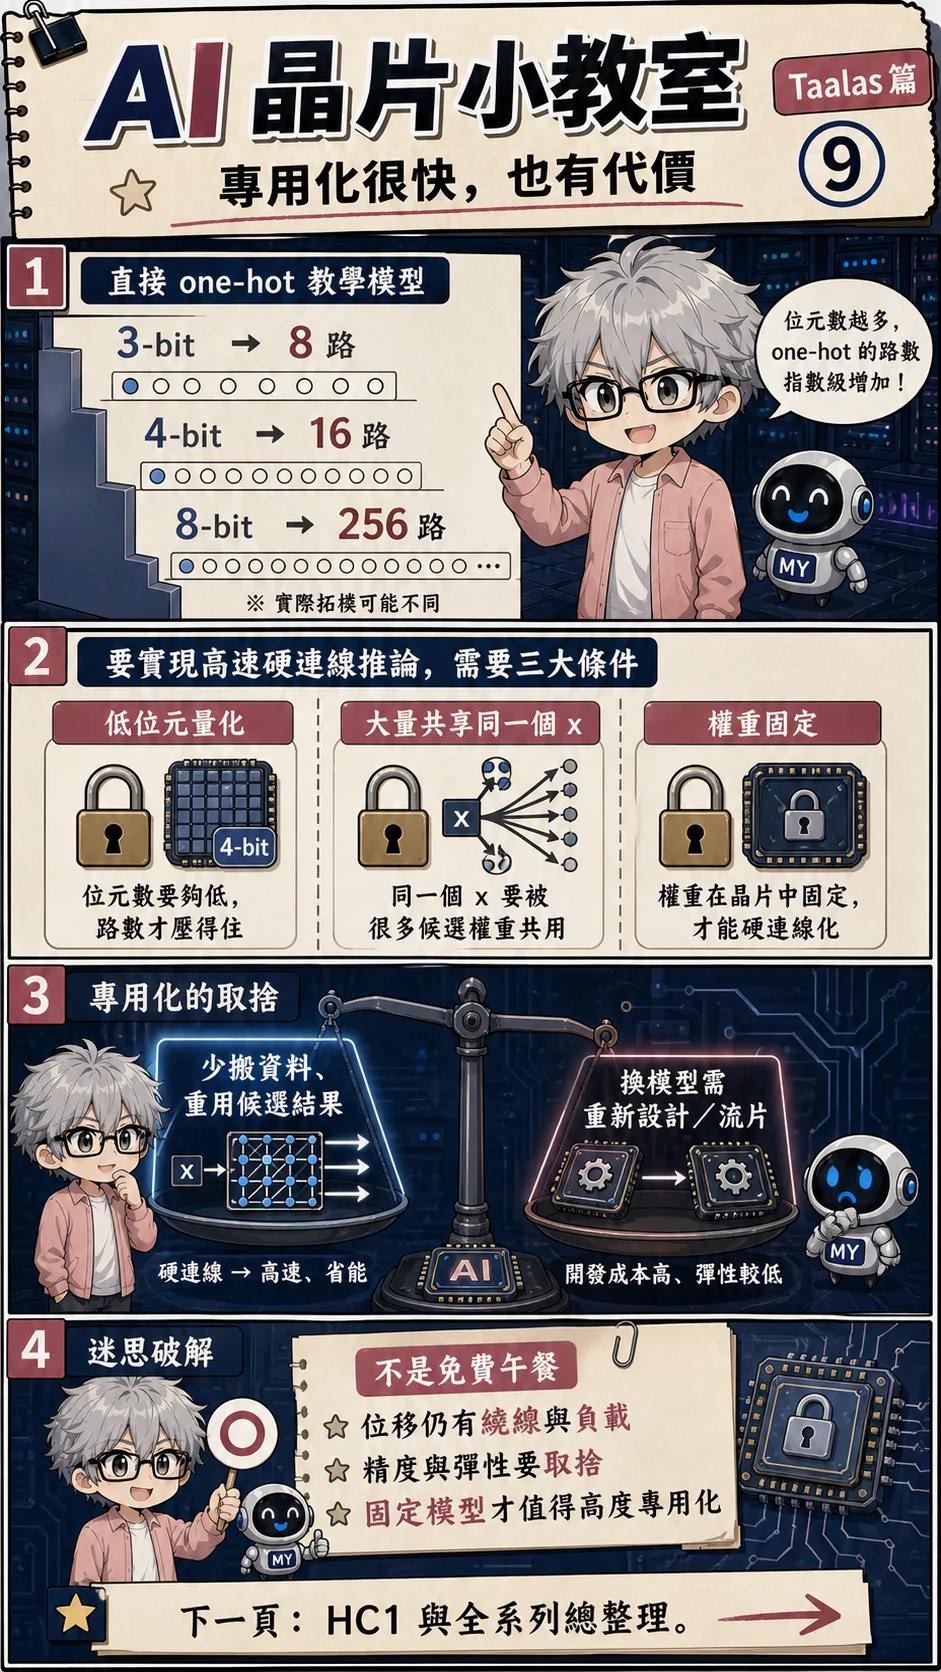
第 5 張埋下的數字在這裡攤開。直接 one-hot:3-bit 8 路、4-bit 16 路、8-bit 256 路。位元數往上加,選擇線不是線性增加。圖上有註:實際拓樸可能不同。這是教學模型的壓力測試,不是在宣布 8-bit 一定比乘法器貴——那要看 decoder、繞線壅塞與乘法器面積怎麼比,漫畫沒給估算表。
三把鎖可以並排看。低位元量化:位元數夠低,路數才壓得住。大量共享同一個 x:建表成本才能攤到很多權重上。權重固定:權重真的做進晶片,資料路徑才能為這個模型客製到很深。少一把鎖,這套故事就沒那麼順。
天平左邊是少搬資料、重用候選結果,硬連線換高速與節能;右邊是換模型要重新設計或流片,開發成本高、彈性較低。位移仍有繞線與負載;精度與彈性要取捨;固定模型才值得高度專用化——這些都不是「免費午餐」的附帶說明,而是同一選擇的另一面。
工程師延伸:真正要收斂的是 PPA 與可更新性
架構評估不能只數乘法器。候選生成、decoder、選擇網路、fan-out、buffer、累加器、clock tree、placement、routing congestion、timing closure 與測試性都會進 PPA。權重若固定在光罩或實體邏輯裡,產品還要回答模型版本、錯誤修補、安全更新與供應生命週期。
因此,硬連線推論比較適合需求穩定、出貨量能攤提 NRE、且模型更換週期可預測的場景。若模型每天變、客戶需要任意 fine-tuning,或同一台機器必須承載大量模型,通用 GPU 與可程式化加速器仍有很強的系統價值。
下一張用 HC1 的官方數字,練習怎麼讀、而不是怎麼背。
10. HC1:把專用化推到極致之後,數字怎麼讀?
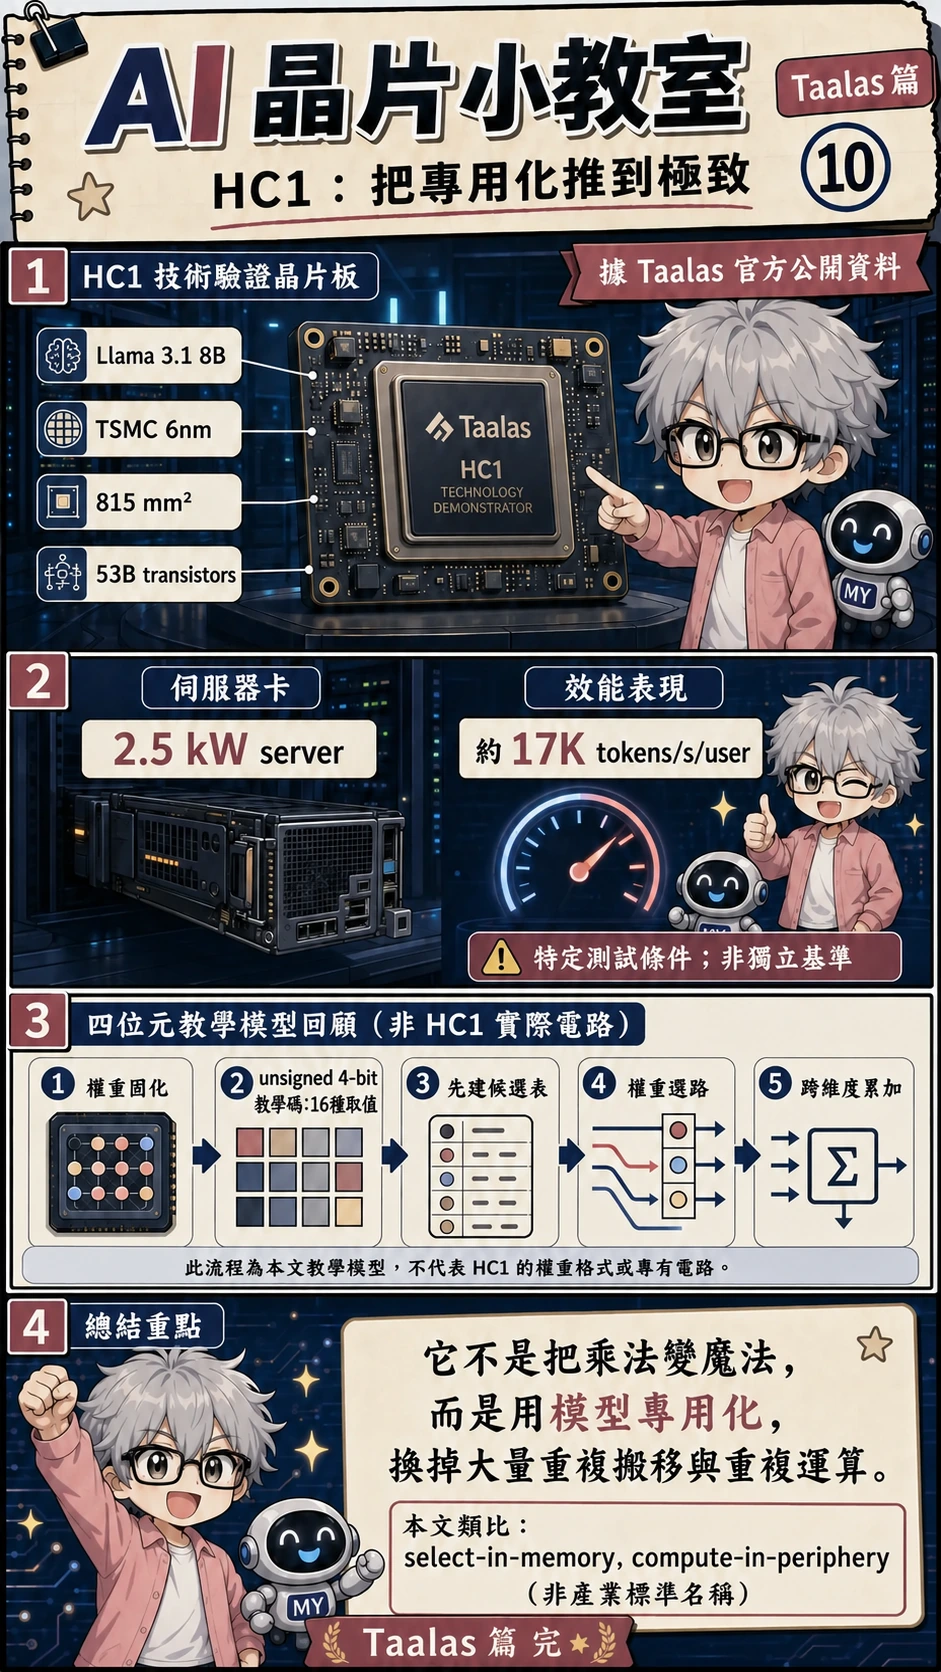
HC1 技術驗證晶片的公開規格可以並排放:Llama 3.1 8B、TSMC 6nm、815 mm²、53B transistors;伺服器功耗 2.5 kW;約 17K tokens/s/user。圖上那枚警告要連同數字一起讀:特定測試條件,不是獨立基準。[2]
產品頁把 HC1 定位成 technology demonstrator。17K 的測試條件是 1K input/1K output。競品數字的來源與量測方式並不完全相同,所以不宜把「快幾倍」寫成跨平台常數。單卡功耗、十卡整機、batch、單使用者延遲與吞吐量,官方頁面上也要分開看,不能混成一個速度。
圖上的五步驟把前面串起來:權重固化 → 4-bit 只有 16 種代碼 → 先建候選表 → 權重選路 → 跨維度累加。收束點不是魔法,而是設計立場——不是把乘法變不見,而是用模型專用化,換掉大量重複搬移與重複運算。漫畫自己寫了本文類比:select-in-memory, compute-in-periphery,並註明這不是產業標準名稱。權重比較像在記憶位置上負責選;數值仍在周邊資料路徑上產生。
這條路能不能擴大到更多模型,還要看晶片重製速度、良率、成本、模型更新節奏,以及真實服務負載下的獨立測試。官方數字可以當起點,不能當結論。
課末五句
- Taalas 把特定模型的權重與資料流高度固化,核心取捨是效率對彈性:少搬權重,換模型通常要重新設計或流片。
- 4-bit 權重只有 16 個代碼,讓同一個 activation 的候選乘積有機會被大量重用;漫畫上的「十五萬次」是在說很多次,不是產品規格。
- one-hot 與 16 格表是教室模型,用來分開「控制」和「資料」。它不是公開的 HC1 電路圖。
- 位移不用通用乘法器,仍然要付繞線、負載、面積、時序與累加成本。「免費」是簡稱,容易誤導。
- 17K tokens/s/user、815 mm²、53B transistors、2.5 kW 都屬 Taalas 官方測試與規格;判讀時必須連同模型、序列長度、功耗與測試來源一起看。
若還想往下問,有兩條路。一條看模型固化後,LoRA、KV cache 與版本更新還能留多少空間。另一條回到 IC 設計,估算 lookup、selector、routing 與 accumulator 的 PPA。不必兩條一起走;記住圖是直覺,數字有邊界,專用化不是免費午餐。
References
- Taalas, The path to ubiquitous AI:Taalas 對 total specialization、儲存與運算合併,以及 HC1 系統定位的官方說明。
- Taalas, HC1 Technology Demonstrator:HC1 模型、製程、晶片面積、電晶體數、伺服器功耗與官方效能測試條件。
- EE Times, Taalas Specializes to Extremes for Extraordinary Token Speed:Taalas 創辦人對 4-bit 參數、單電晶體乘法相關工作與全數位運算的公開說明。
- Geens et al., Hardware Generation and Exploration of Lookup Table-Based Accelerators for 1.58-bit LLM Inference:LUT 型低位元 LLM 加速器的設計空間與 activation 型別取捨。
Hashtags: #Taalas #HC1 #硬連線推論 #AI推論 #AI晶片 #ASIC #HBM #MemoryWall #四位元量化 #OneHot #半導體 #漫畫小教室
互動練習:16 格候選表與固定選路
三個 activation 分別建立 0x–15x 候選表,兩個輸出用固定權重選路後累加。修改想要的第一個權重,觀察舊選路是否還算對;再重新編譯選路比較。
這是 unsigned 4-bit 碼、整數精確算術的功能模型,不是 HC1 電晶體實作、RTL 時序或量化 LLM。沒有 overflow、縮放係數、佈線成本與 fan-out 模擬。「重新編譯」只改本頁陣列;真實固定模型的變動可能需要重新設計與流片,產品保留的可配置部分則另論。
學習指南
AI 技術小教室
先備知識
- 基本矩陣向量乘法與低位元量化概念
我學會了什麼
- 說明固定低位元權重為何能重用候選乘積
- 能沿著漫畫把 4-bit 權重從建表、one-hot 選路講到跨維度累加
- 能帶著測試邊界讀 HC1 官方數字,而且不把漫畫當成晶片電路圖