同樣 3GHz,怎麼選比較快的電腦?
頻率相同,程式完成的時間仍可能不同。先沿著工廠的產線找等待,再把觀察接回 CPU 的運作。九張漫畫提供直覺,正文說明每種機制如何幫忙,以及何時幫不上忙。
假設你要替兩台電腦選一台來處理資料。兩顆 CPU 都標示 3GHz,核心數也相同。只用一個核心跑同一份程式,A 卻比 B 早完成。這是本課的教學情境,不是特定產品的測試結果。規格表上的頻率一樣,差別究竟藏在哪裡?
CPU 的時鐘規定每秒有多少個週期。每個週期做成多少事,要看核心內部如何運作。我們沿用漫畫裡的工廠來追這件事。工單能否及時送到?工人等料時能否先做別的工作?一路看下去,就能分辨「週期變短」與「等待變少」這兩種加速。
1. 同樣 GHz,效能為什麼會差兩倍?
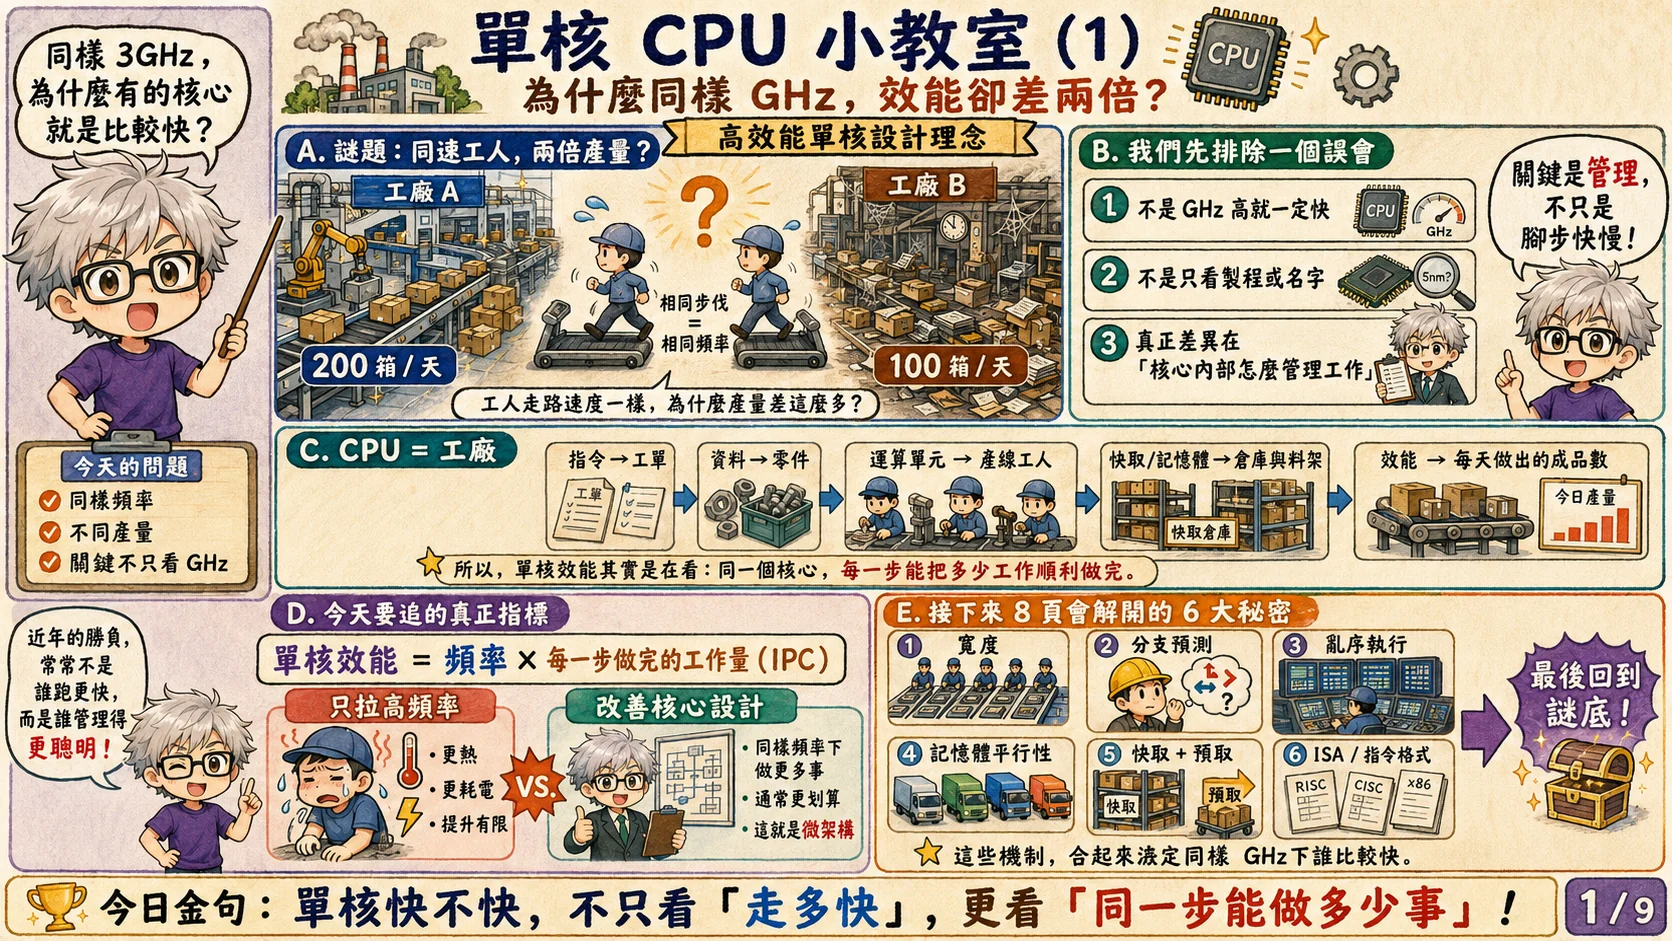
3GHz 代表每秒約三十億個時鐘週期。一個週期是硬體推進工作的時間單位。它不保證 CPU 剛好完成一條指令。有些指令需要好幾個週期。核心也可能在同一週期完成多條指令。只知道週期有多短,還無法知道程式何時跑完。
想像兩座工廠收到相同的一批訂單。工人步調一樣,A 的材料卻總能及時到位。B 常要停下來找料,或等下一張工單。一天結束,A 的產量便可能比較多。對應到 CPU,指令是工單,資料是材料。執行單元負責運算,快取存放附近常用的資料。前端則負責取得指令,並解讀要做的操作。
我們用 IPC 觀察每個週期的產量。IPC 是 Instructions Per Cycle 的縮寫。本課用「已退休的指令數 ÷ 時鐘週期數」來計算。退休是指核心正式確認指令的結果。猜錯路徑後丟掉的指令,不列入這個產量。IPC 是整段執行的平均值,也會隨程式改變。
接下來的六種機制,各自處理不同的等待。寬度增加同時處理工作的空間。分支預測先準備下一條路徑。亂序執行找出能先做的指令。記憶體平行性讓多筆讀取同時在路上。快取與預取處理資料供應,指令格式影響前端。它們會互相牽動,不能把各自的好處直接相加。
2. 頻率與 IPC:如何算出執行時間?
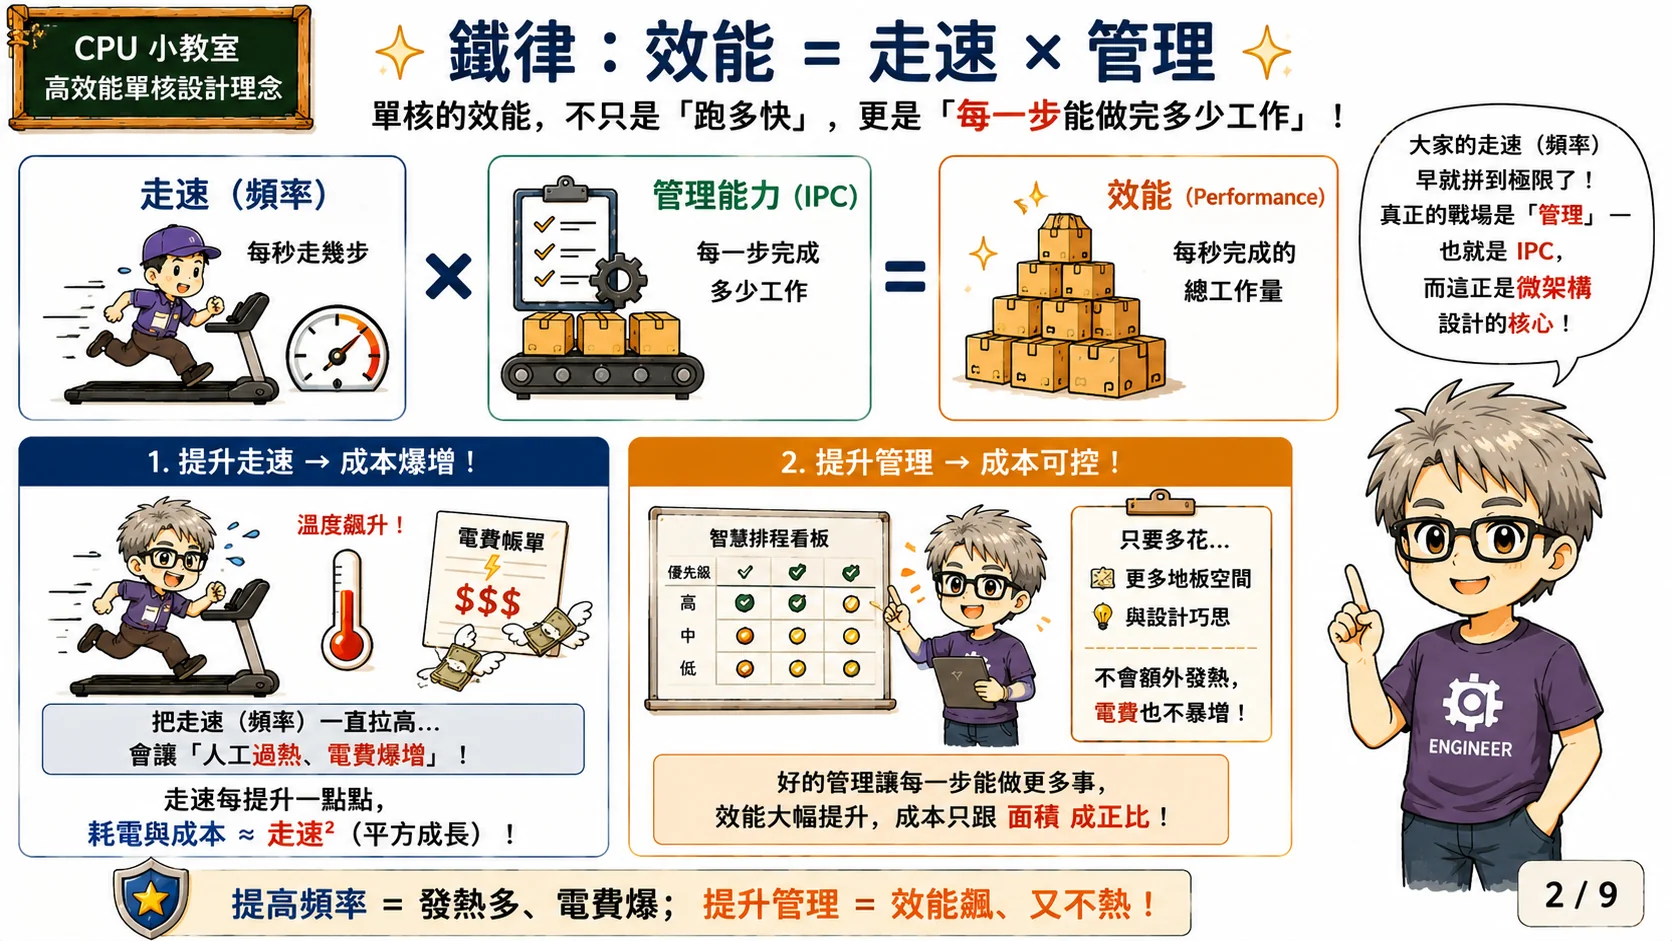
同一份工作需要多少時間,可以拆開來算。先數它實際執行並退休多少條指令。再用平均 IPC 算出所需週期。最後用頻率換成秒數。關係是「執行時間 = 指令數 ÷(IPC × 頻率)」。圖中的「走速 × 管理」,可以幫助記住後半部。但比較不同程式或指令集時,還要保留指令數。
用一個簡化例子算看看。假設兩顆核心都要退休三十億條指令。頻率都維持 3GHz。A 的平均 IPC 是 2,B 是 1。A 需要十五億個週期,約 0.5 秒。B 需要三十億個週期,約 1 秒。這些是教學數字,未包含其他系統等待。兩倍差距來自週期用量,不需要先提高 GHz。
提高頻率也能縮短每個週期。但電路必須在更短的時間內送出正確結果。設計者可能要提高電壓,或重新切分管線。動態切換功耗常用 P ≈ αCV²f 估算。其中 α 是切換活動比例,C 是有效電容。V 是電壓,f 是頻率。這個式子不包含所有漏電與系統功耗。若電壓也提高,耗電增加就可能超過頻率的增幅。
提高 IPC 也要付出硬體成本。更大的指令追蹤空間,可以找到更多工作。更寬的前端和更多運算單元,則要耗用面積與電力。設計者還得驗證它們能否正確合作。產品最後要在效能與這些成本之間取捨。實際比較時,要固定工作與輸入,也要記錄編譯設定及執行環境。SPEC 的測試規則可用來理解這些比較條件。
3. 設計理念 #1:寬度
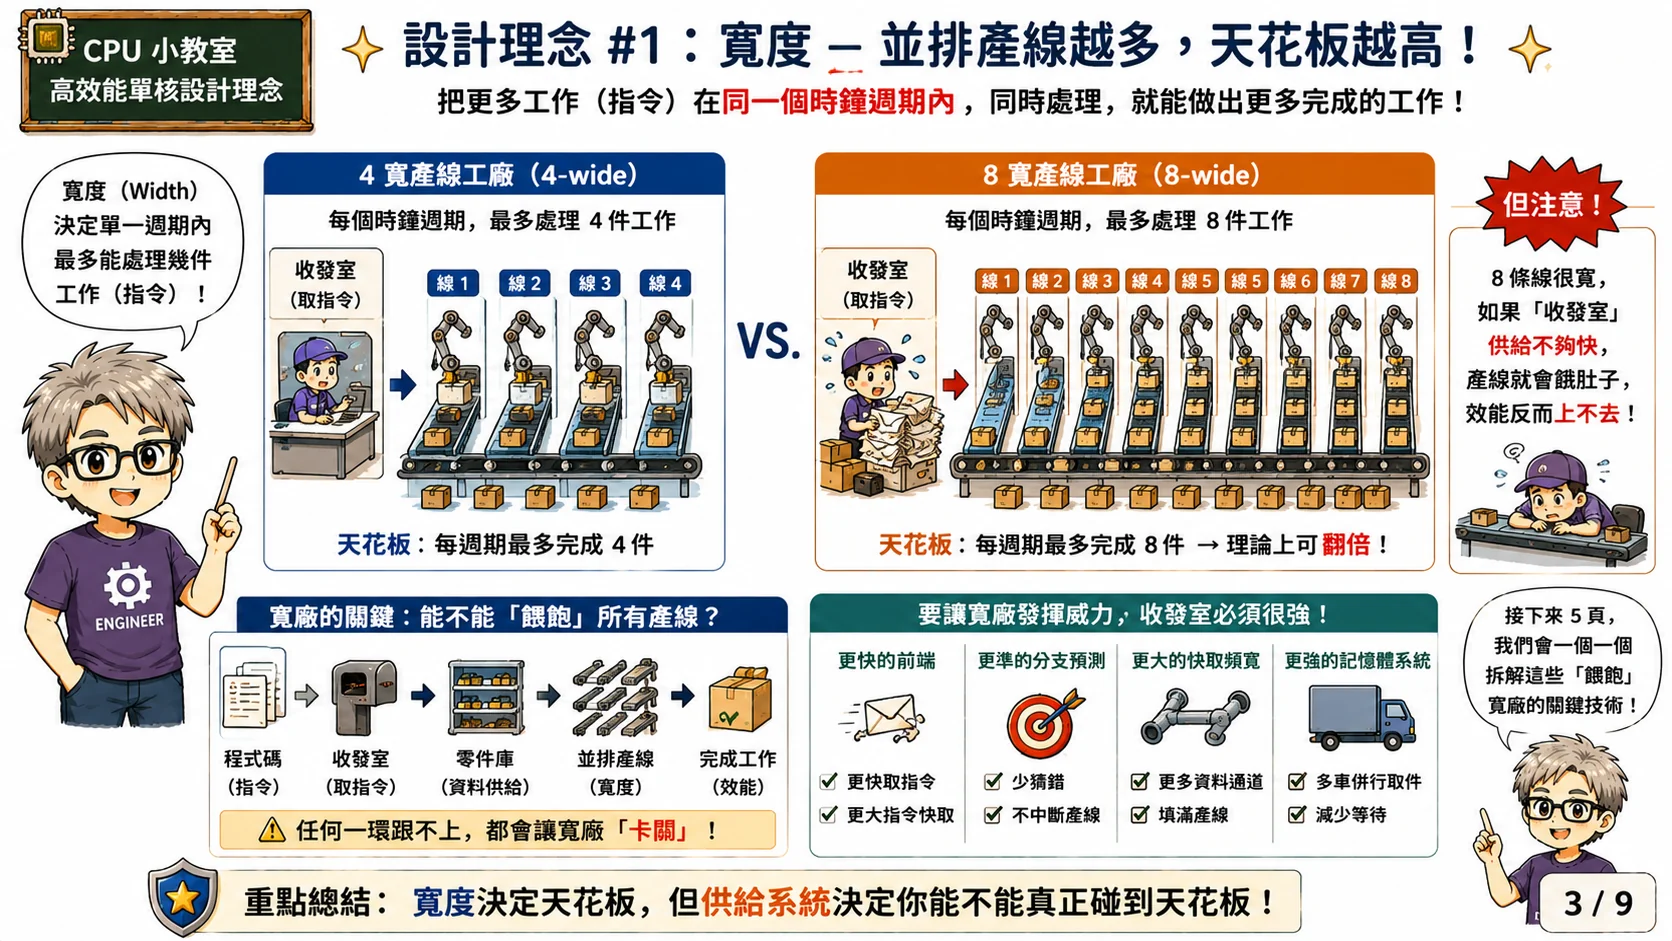
工廠可以增加產線,CPU 也能增加每週期的處理量。這類設計稱為超純量(superscalar)。不過,「8-wide」必須說明指哪個階段。取指、解碼與發射的寬度可以不同。退休寬度也可能不同。某些階段還以微操作計數。微操作是核心內部拆出的工作單位,不一定等於軟體看到的一條指令。
先把圖中的 4-wide 與 8-wide 當成簡化產線。若八張工單都已備妥,八條產線有機會一起工作。若收發室每次只送來兩張,其餘產線就會閒著。CPU 也有這種供應問題。指令快取找不到資料,前端就要等。解碼跟不上,後端也拿不到足夠的操作。加寬其中一段,未必能提高整條管線的產量。
程式本身也會限制平行工作。假設 B 要用 A 算出的結果,C 又要用 B 的結果。A、B、C 就形成一條相依鏈。即使有八個運算單元,也得先等 A 算完。若是八筆互不相依的運算,就有較多平行機會。這種機會稱為指令層級平行性,簡稱 ILP。核心需要找得到它,也要有適合的執行單元。
加寬設計會增加資料通路與控制電路。暫存器要支援更多存取,排程器也要做更多選擇。這可能增加耗電,並讓時脈更難拉高。因此,8-wide 提供較高的某階段上限。它沒有承諾每個程式都能得到兩倍效能。回到選電腦的問題,還得問那份程式能否供應足夠的獨立工作。
4. 設計理念 #2:分支預測
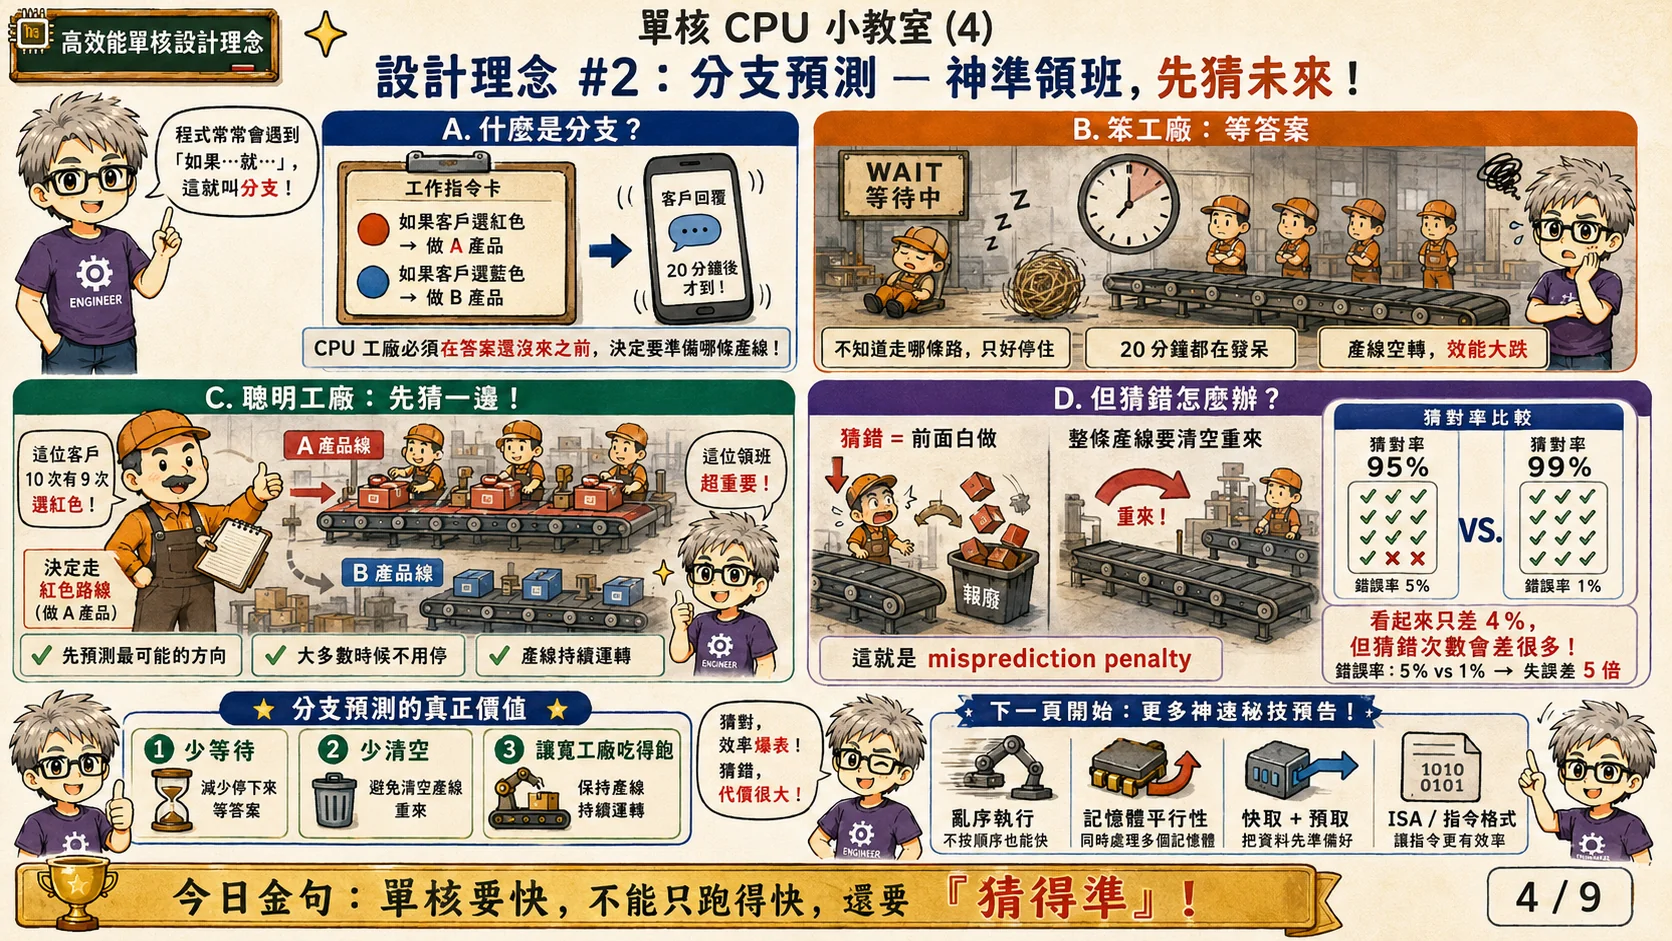
產線收到一張「符合條件才加工」的工單。條件要等材料檢查後才能確定。CPU 跑到 if/else,也會遇到類似問題。迴圈與函式返回同樣會改變下一個指令位置。若前端每次都等答案確定才取指,後面的運算單元可能沒有新工作可做。
分支預測器會先估計下一個指令位置。核心沿著預測路徑準備工作,甚至先執行。這些結果暫時還不能當成正式答案。條件確定後,核心會檢查預測。猜對就能繼續;猜錯則撤銷錯誤路徑的指令,再從正確位置出發。重新準備工作會花時間,稱為錯誤預測代價。
圖中的 95% 與 99%,差了四個百分點。假設都預測一百次,前者錯五次,後者錯一次。錯誤次數便從五次降為一次,少了 80%。但整個程式不會因此固定快 80%。加速多少,要看分支出現頻率與每次猜錯的代價。也要看這些代價是否和其他等待重疊。
預測也包含不同問題。方向預測判斷條件分支走哪邊。分支目標緩衝區(BTB)協助找跳轉位置。返回位址堆疊(RAS)則協助預測函式返回。更寬或更深的管線,可能讓一次錯誤浪費更多準備工作。設計者必須同時考慮準確度、查表速度與硬體成本。若開頭那份程式經常分支,這一環就值得優先觀察。
5. 設計理念 #3:亂序執行
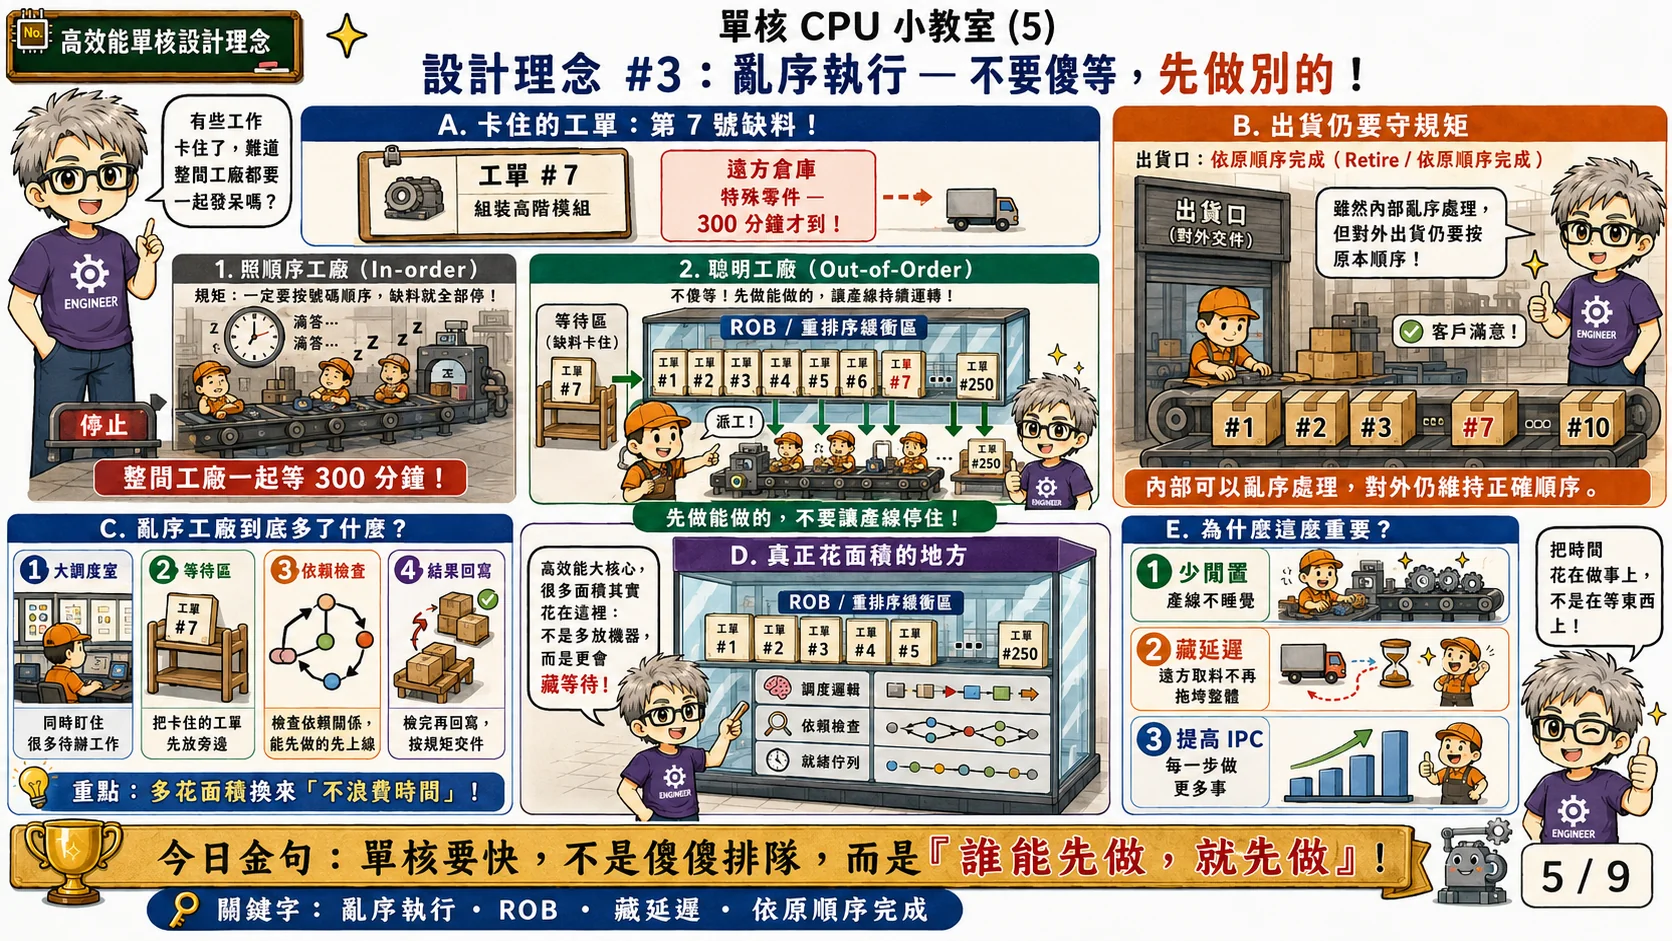
再看另一種停工。工單 A 正在等材料,B、C、D 的材料卻已到齊。若工廠只能照順序開工,後三張也得等。循序執行核心就可能遇到這種阻塞。它的控制通常較簡單。但前方指令無法推進時,後方獨立工作也可能用不到空著的運算單元。
亂序執行核心會查看一批尚未退休的指令。排程器找出資料已備妥的工作,交給可用的執行單元。於是 A 等待時,B、C、D 可以先算。B 若需要 A 的結果,仍然必須等 A。硬體可以利用獨立工作,卻不能消除真正的資料相依。
先算完與正式退休,是兩件不同的事。重排序緩衝區(ROB)追蹤原本的指令順序。典型亂序核心依序退休,確認可保留的結果。暫存器重新命名可分開重複使用的名稱。載入/儲存佇列則協助檢查記憶體相依。核心還得正確處理例外與錯誤預測。讀者可在 gem5 O3CPU 模型看到這些階段如何合作。依序退休也不代表所有記憶體操作都只能依序發出。
追蹤空間有限,核心無法無限往後找。若指令全都依賴 A,排程器就找不到替代工作。若 A 等太久,ROB 填滿後也可能停住。更大的 ROB 與排程器,可以看得更遠。它們也增加面積、耗電與驗證負擔。亂序執行的收益,取決於等待期間有多少獨立工作可做。
6. 設計理念 #4:記憶體平行性 MLP
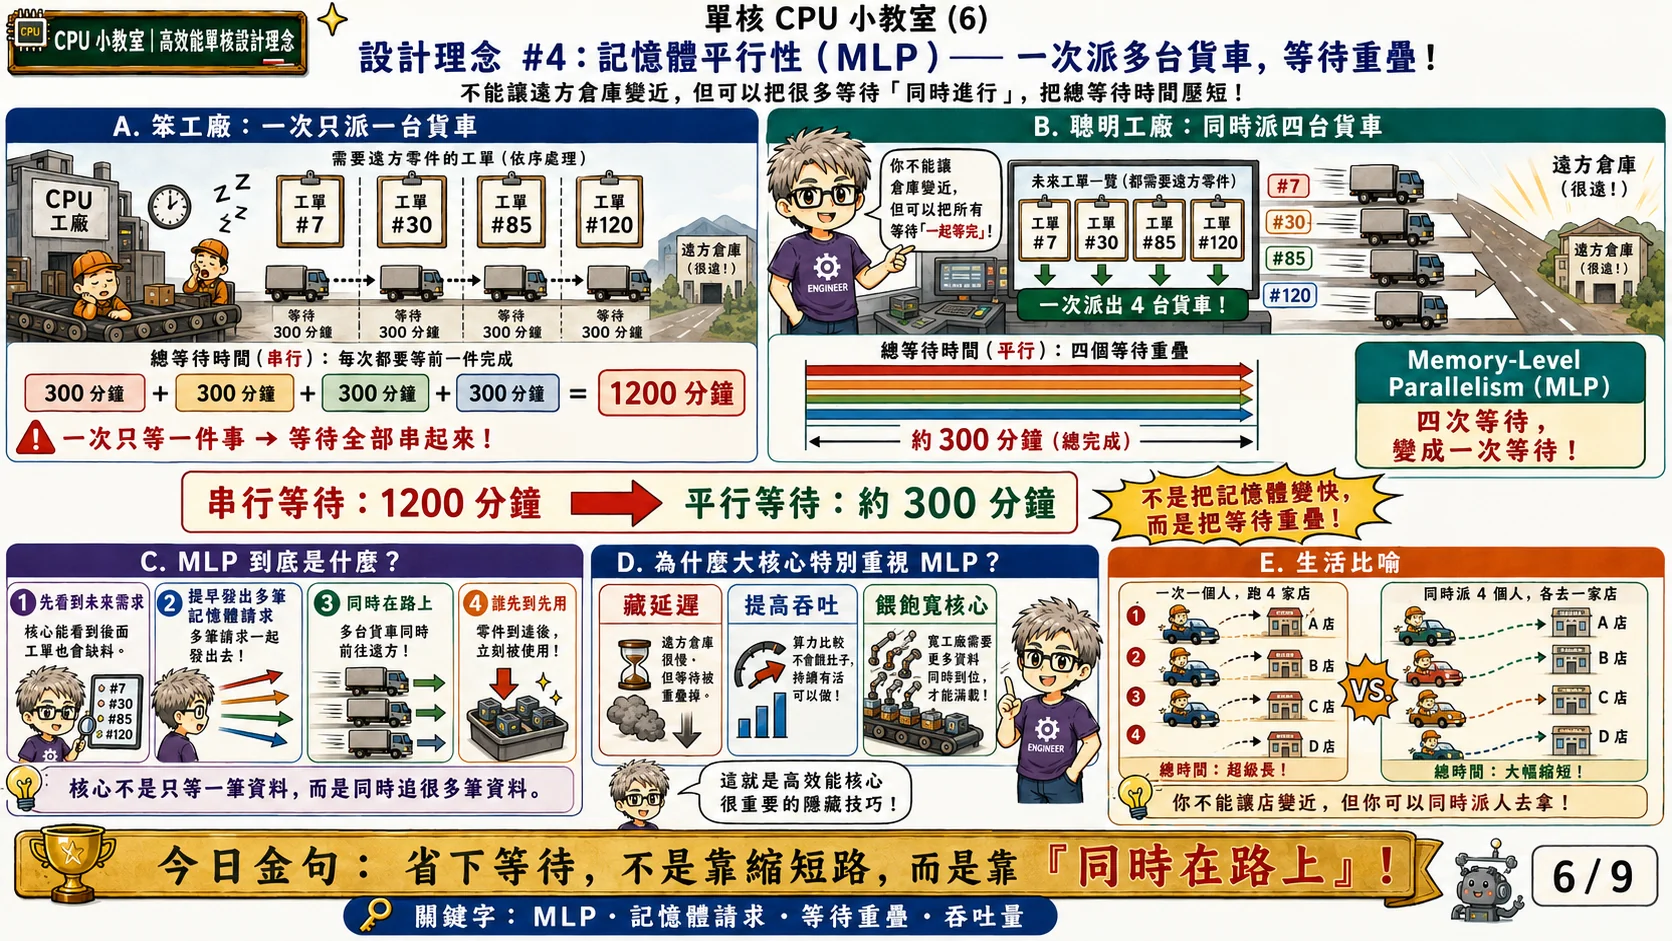
工廠有時等的不是一車材料,而是好幾車。CPU 也可能需要多筆尚未到達的資料。快取未命中(cache miss)後,請求得往下一層找。若一路到 DRAM,等待可能達數百個 CPU 週期。實際延遲會隨平台及負載改變。每次只等一筆,這些等待就會接在一起。
先用圖中的四台貨車理解時間重疊。四趟各花 300 分鐘,完全串行要 1200 分鐘。若能一起出發,理想等待約為 300 分鐘。分鐘只是圖中的運輸比喻。換到 CPU,可以假設四筆讀取各等 300 個週期。若位址已知且彼此獨立,就有機會重疊等待。每一筆仍然很慢,但總時間可能縮短。
這種能力稱為記憶體平行性,簡稱 MLP。核心要能提早找到多筆讀取,並追蹤未完成的請求。非阻塞快取可以在等待時繼續處理其他請求。未命中狀態追蹤暫存器(MSHR)記錄尚未取回的快取區塊。載入/儲存佇列與 ROB 也要留有空間。gem5 的快取文件提供了非阻塞快取與 MSHR 的模型範例。
四筆讀取不一定能一起出發。沿著鏈結串列找下一個節點時,下一個位址要等前一筆資料回來才知道。這就難以靠 MLP 重疊。即使請求獨立,頻寬與佇列容量也可能限制速度。四筆各等 300 個週期,是理想化例子,不是四倍加速的保證。判斷記憶體瓶頸時,要分開看單筆延遲與同時處理量。
7. 設計理念 #5:快取與預取器
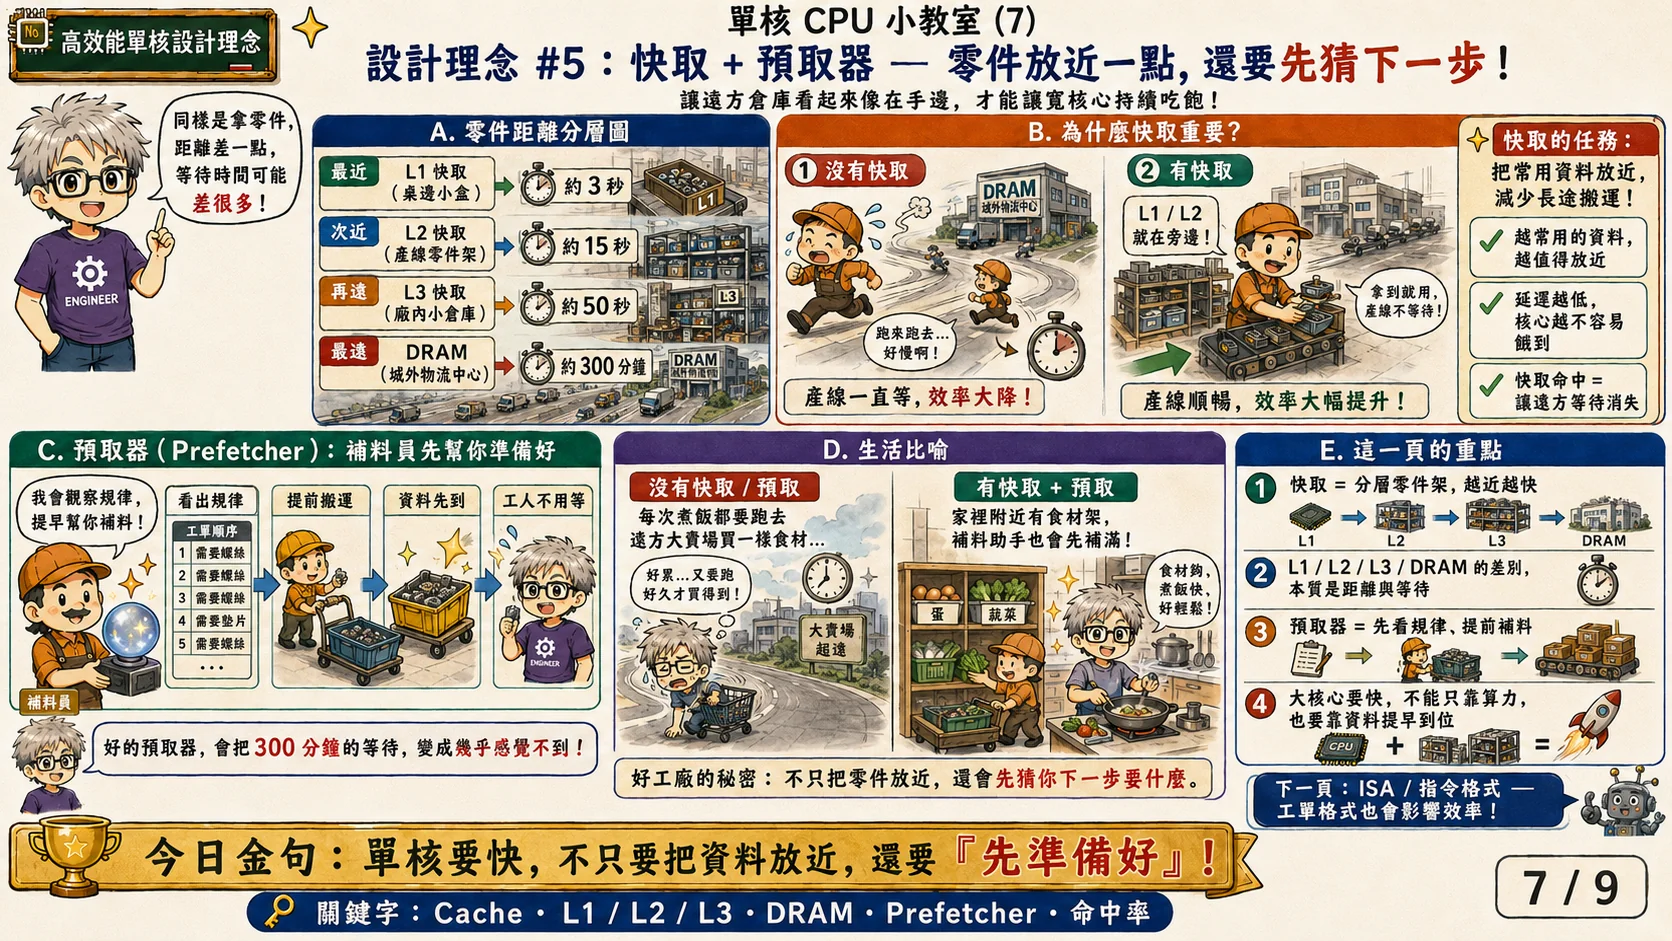
工廠能不能少等料,也取決於倉庫配置。CPU 通常會把資料分放在不同層級。L1 快取容量小,存取延遲通常最低。L2 容量較大,存取一般較慢。部分設計另有 L3,再往外才是 DRAM。圖中的距離代表等待時間,不是實際公尺數。快取層數及是否共享,會隨處理器設計改變。
快取利用程式常見的區域性。剛讀過的資料,稍後可能又會使用。這叫時間區域性。掃描陣列時,下一個元素通常就在附近。這叫空間區域性。快取以區塊保存資料,鄰近元素可能一起被帶進來。程式便能少跑幾趟 DRAM。容量不足或區塊互相排擠時,仍然會發生未命中。
預取器則嘗試在程式需要之前搬資料。連續掃描陣列,常有可觀察的存取規律。預取器可以提早請求後面的區塊。若資料及時到達,後續讀取就能少等。但不規則存取較難預測。預取太早或猜錯,會占用頻寬與快取空間。它甚至可能把即將使用的資料擠出去。
這三種記憶體機制可以一起理解。快取保留附近可能再用的資料。預取器提早搬入可能需要的資料。MLP 讓仍需等待的請求盡量重疊。增加快取,只有在它能留下有用資料時才會有幫助。若開頭的程式一直等待資料,應先觀察存取模式與工作集。工作集是那段執行期間需要使用的資料範圍。單看快取容量,還不能推算加速幅度。
8. 設計理念 #6:ISA / 指令格式
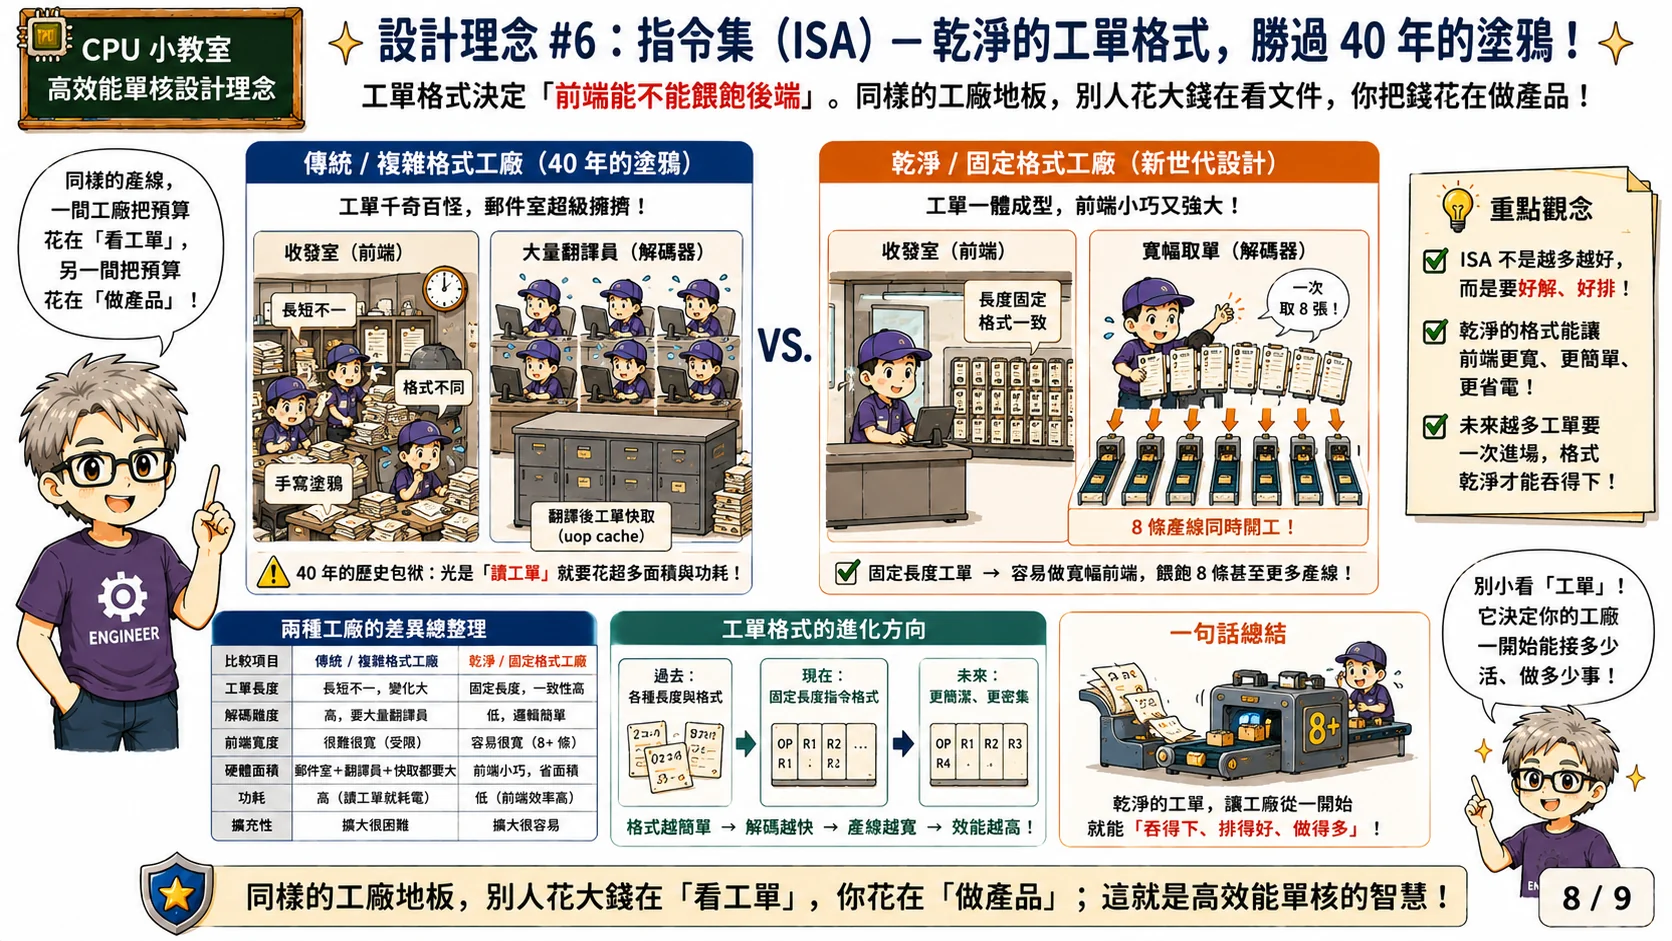
工廠除了等料,也要讀懂工單。CPU 的指令集架構稱為 ISA。它約定指令如何編碼,以及每種操作的意義。暫存器與記憶體存取規則也屬於契約。相關架構規格還定義例外及中斷行為。軟體依契約寫程式,硬體則必須實現它。核心內部怎麼排程,是微架構的設計選擇。
規整的格式可以簡化某些前端工作。例如指令長度固定,邊界就較容易定位。長度變動時,前端需要判斷指令從哪裡開始、在哪裡結束。部分核心還會把指令拆成微操作。但「規整」不等於所有指令都一樣長。RISC-V 的 C 擴充允許 16 位元與 32 位元指令混用。這是為了減少程式碼占用空間,並兼顧解碼。RISC-V C 擴充規格有說明這種取捨。
程式碼密度也會影響供應。相同功能若能用較少的指令位元組表達,指令快取就可能容納更多工作。但操作本身的意義也很重要。有些工作能用向量指令一次處理一批資料。編譯器能否有效使用這些指令,同樣影響結果。因此,不能只用解碼難度替整個 ISA 排名。更簡單的格式,也不會自動保證更高效能。
跨 ISA 比較時,要回到同一份工作的完成時間。兩邊可能用不同的指令數,也可能把一條指令拆成不同數量的微操作。IPC 數字高的一方,不一定較早完成。圖中的標準化工單,適合用來理解前端成本。它無法單獨判定哪種指令集最快。選電腦時,應把 ISA、編譯器與微架構放回同一個測試條件。
9. 回到開頭:同樣 GHz,時間差在哪裡?
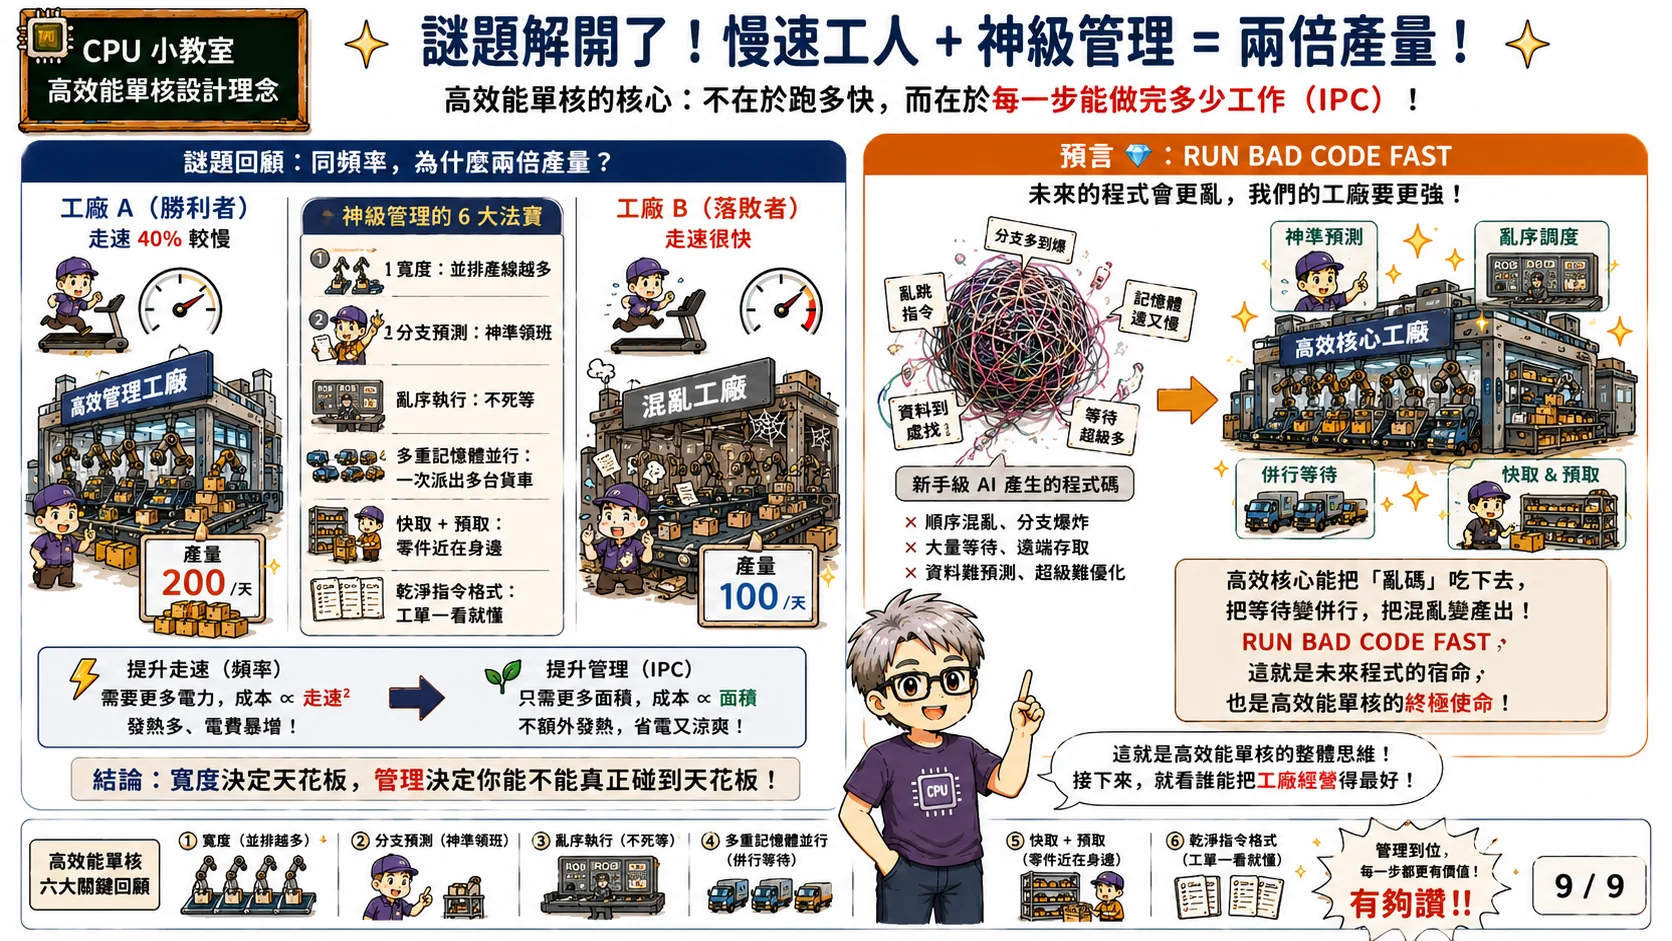
回到兩台都標示 3GHz 的電腦。相同頻率,只固定了每秒的週期數。A 若減少等待,就可能用較少週期完成工作。圖中的每天 200 箱與 100 箱,是產量差異的比喻。它沒有宣稱任何一款 CPU 都快兩倍。要確認那份程式的差距,仍然需要實際量測。
現在可以沿著等待的位置找原因。指令供應不足,就觀察前端與分支。資料到齊卻不能一起算,就檢查相依與執行資源。資料還在遠處,就觀察快取未命中及請求重疊。寬度提供處理空間,亂序執行找可做的工作。它們得和供應機制合作,才能提高平均 IPC。
圖中的 RUN BAD CODE FAST,是一種設計目標的說法。這裡指的是分支多、存取不規則的程式。它不表示 CPU 能把錯誤程式算成正確答案。硬體仍要維持程式定義的結果。它只能在有限的面積與功耗內,盡量減少等待。軟體若改善資料布局或相依鏈,也可能讓硬體更容易發揮。
最後換一個條件。若程式沿著鏈結串列逐節讀取,加寬產線能保證加速嗎?不能保證。下一個位址要等資料回來才知道,獨立工作可能很少。這也限制 MLP。本課尚未深入討論向量執行、TLB 位址轉換,以及作業系統排程。先掌握這九頁的等待邏輯,再進入多核心吞吐量小教室。下一個問題是:增加核心後,哪些工作仍然必須排隊?
Hashtags
#CPU #SingleCorePerformance #IPC #Microarchitecture #OutOfOrderExecution #BranchPrediction #Cache #Prefetcher #MLP #ISA #RISCV #ProcessorDesign #SemiconductorTechnology #高效能CPU #單核效能 #微架構 #漫畫小教室
References
- SPEC CPU 2017 Overview - 說明 CPU2017 的 speed / rate benchmarking 背景,可用來區分單工效能與吞吐量測。
- SPEC CPU 2017 Run and Reporting Rules - 補充 SPEC speed / rate 執行規則與結果呈現脈絡。
- gem5 O3CPU Documentation - 支撐 out-of-order、execute-in-execute、ROB / commit 等高效能核心模型說明。
- gem5 Memory System Documentation - 支撐 cache hierarchy、memory request 與記憶體系統模型背景。
- Linux Kernel Documentation: Cache and TLB Flushing - 支撐 cache / TLB 是處理器與作業系統共同管理的重要層級。
- Linux Kernel Documentation: Memory Management Concepts - 補充記憶體階層、位址轉換與 page / cache 相關背景。
- RISC-V ISA Manual Releases - 支撐 ISA / 指令格式與開放指令集規格脈絡。
- Agner Fog: The Microarchitecture of Intel, AMD and VIA CPUs - 以實務角度整理 branch prediction、out-of-order、cache、instruction decoding 等微架構特性。
- Hennessy and Patterson, Computer Architecture: A Quantitative Approach - 經典電腦架構教材,支撐效能量化、ILP、memory hierarchy 等核心概念。
- gem5 Classic Caches - 非阻塞快取、MSHR 與未完成請求的模型。
- RISC-V C Extension, Version 2.0 - 16 位元壓縮指令與 32 位元指令混用的規則。
學習指南
CPU 小教室系列
先備知識
- 時脈頻率與基本指令流程
我學會了什麼
- 說明為何相同 GHz 不代表相同效能
- 把 IPC 與預測、排程、快取及預取連結起來
- 辨識記憶體平行性及其限制